
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
Se você já tentou extrair dados de um site moderno, conhece a dor: bloqueios de IP, paredes de CAPTCHA e conteúdo renderizado por JavaScript que retorna apenas uma casca HTML vazia. Construir sua própria infraestrutura de scraping para lidar com esses problemas é caro e demorado.
O Scrapestack promete resolver tudo isso com uma única chamada de API REST. Mas será que cumpre o que promete? Nesta análise, vamos detalhar exatamente o que o Scrapestack oferece, quem deve usá-lo, onde ele fica aquém e como se compara a outras opções no mercado.
Análise do Scrapestack 2026: Preços, Recursos e Casos de Uso - imagem de suporte à pesquisa de produto 1.
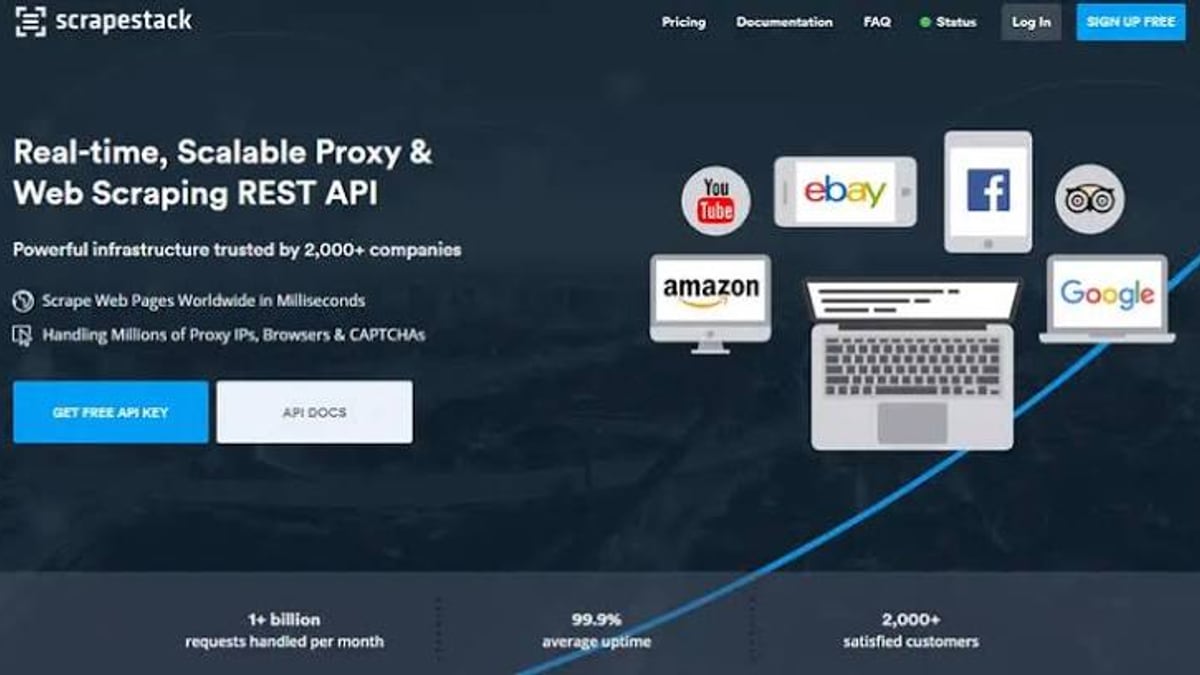
O Scrapestack é uma API REST de web scraping em tempo real mantida pela apilayer, uma empresa sediada em Londres e Viena conhecida por seus produtos API como serviço. O serviço cuida do trabalho pesado do web scraping: rotação de proxies, resolução de CAPTCHA, renderização JavaScript e geolocalização — tudo através de um único endpoint.
Em vez de gerenciar seu próprio pool de proxies, navegadores headless e lógica de repetição, você envia uma URL para o Scrapestack e recebe o HTML renderizado de volta. A infraestrutura por trás processa mais de 1 bilhão de solicitações por mês com 99,9% de uptime e é confiável por mais de 2.000 empresas.
Análise do Scrapestack 2026: Preços, Recursos e Casos de Uso - imagem de suporte à pesquisa de produto 2.
A interação principal é simples: uma solicitação HTTP GET para o endpoint da API do Scrapestack com sua URL de destino e chave de API.
GET https://api.scrapestack.com/scrape
  ?access_key=SUA_CHAVE_API
  &url=https://exemplo.com
Nos bastidores, o Scrapestack:
Você recebe o HTML completo da página — exatamente o que um usuário real veria em seu navegador.
O Scrapestack mantém um pool de mais de 35 milhões de endereços IP abrangendo proxies de datacenter e residenciais em dezenas de ISPs globais. Cada solicitação pode passar por um IP diferente, dificultando a detecção e o bloqueio da atividade de scraping pelos sites de destino.
Construir essa infraestrutura por conta própria custaria milhares por mês apenas em assinaturas de proxy.
Sites modernos construídos com React, Angular ou Vue renderizam conteúdo no lado do cliente. Uma solicitação HTTP padrão retorna uma página esqueleto sem dados úteis. O Scrapestack executa um navegador Chrome headless completo em cada solicitação quando necessário, executando JavaScript e retornando o DOM renderizado final.
Este recurso é essencial para scraping de sites de e-commerce, plataformas de mídia social, portais de notícias e painéis SaaS.
CAPTCHAs são um dos maiores bloqueadores no web scraping. O Scrapestack integra resolução automatizada de CAPTCHA para Google reCAPTCHA, hCaptcha e outros sistemas de desafio. Isso acontece de forma invisível — sem necessidade de configuração adicional.
Precisa ver conteúdo que só é visível na Alemanha, Japão ou EUA? O Scrapestack permite especificar o país de origem das suas solicitações com um único parâmetro. Isso é valioso para pesquisa de mercado, comparação de preços, testes de localização e inteligência competitiva.
O Scrapestack funciona com qualquer linguagem de programação que possa fazer uma solicitação HTTP: Python, Node.js, PHP, Ruby, Go, Java e muito mais. A documentação da API inclui exemplos de código funcionais, e a integração normalmente leva menos de 15 minutos para desenvolvedores experientes.
O serviço lida com mais de 1 bilhão de solicitações por mês com 99,9% de uptime. Quer você esteja fazendo scraping de 1.000 páginas para um projeto paralelo ou 10 milhões para pipelines de dados empresariais, a infraestrutura escala sem degradação.
O Scrapestack oferece um plano gratuito e vários níveis pagos:
| Plano | Preço | Solicitações/Mês | Principais Recursos |
|---|---|---|---|
| Gratuito | $0 | 100 | Proxies padrão, HTTPS, solicitações concorrentes, renderização JS, 100+ locais |
| Básico | $19,99/mês | 50.000 | Todos os recursos gratuitos + proxies premium, suporte prioritário |
| Profissional | $79,99/mês | 500.000 | Limites de solicitação mais altos, recursos avançados |
| Empresarial | Personalizado | Personalizado | Infraestrutura dedicada, SLA, integrações personalizadas |
O plano gratuito não requer cartão de crédito e é ideal para testes. Descontos para faturamento anual estão disponíveis.
Comparado a concorrentes como ScrapingBee, o preço do Scrapestack é competitivo para usuários de volume médio. O plano Básico a $19,99 oferece 50.000 solicitações, enquanto o nível similar do ScrapingBee começa em $49 por 100.000 solicitações.
Análise do Scrapestack 2026: Preços, Recursos e Casos de Uso - imagem de suporte à pesquisa de produto 3.
O Scrapestack pode extrair preços de produtos, disponibilidade e descrições de sites concorrentes. A renderização JavaScript garante que você obtenha conteúdo carregado dinamicamente, enquanto a rotação de IP evita bloqueios durante verificações frequentes.
Extraia informações de contato, listagens de empresas e dados de empresas de diretórios e sites de avaliação. A geolocalização permite focar em mercados específicos.
Colete artigos, manchetes e metadados de sites de notícias. A manipulação de CAPTCHA garante que você não fique preso atrás de páginas de desafio.
Acompanhe classificações de palavras-chave, meta descrições e recursos SERP em diferentes locais. A geolocalização é particularmente útil para análise de SEO local.
curl "https://api.scrapestack.com/scrape?access_key=SUA_CHAVE&url=https://exemplo.com"
render_js=1:curl "https://api.scrapestack.com/scrape?access_key=SUA_CHAVE&url=https://exemplo.com&render_js=1"
Adicione geolocalização com o parâmetro country (use códigos de país como us, de, jp)
Integre em seu código — aqui está um exemplo em Python:
import requests

response = requests.get('https://api.scrapestack.com/scrape', params={
    'access_key': 'SUA_CHAVE_API',
    'url': 'https://exemplo.com',
    'render_js': '1'
})

html = response.text
print(html)
Para configurações de scraping mais avançadas, você pode combinar o Scrapestack com navegadores anti-detecção como AdsPower para gerenciamento de sessão, ou usar Beautiful Soup para analisar o HTML retornado.
Análise do Scrapestack 2026: Preços, Recursos e Casos de Uso - imagem de suporte à pesquisa de produto 4.
| Recurso | Scrapestack | ScrapingBee | Bright Data |
|---|---|---|---|
| Preço Inicial | $19,99/mês | $49/mês | Personalizado |
| Nível Gratuito | 100 req/mês | 1.000 req/mês | Não |
| Renderização JS | Sim | Sim | Sim |
| Resolução de CAPTCHA | Sim | Sim | Sim |
| Proxies Residenciais | Sim | Sim | Sim |
| Análise Integrada | Não | Não | Não |
| Tipo de API | REST | REST | REST |
O Scrapestack é uma opção sólida de meio-termo — mais acessível que soluções empresariais como Bright Data, mas com menos recursos que alguns concorrentes de médio porte. Sua força reside na simplicidade e confiabilidade, em vez de funcionalidades avançadas.
Sim, o Scrapestack oferece um plano gratuito com 100 solicitações por mês. Não é necessário cartão de crédito para se inscrever.
Sim. Adicione o parâmetro render_js=1 à sua solicitação, e o Scrapestack usará um navegador Chrome headless para renderizar JavaScript antes de retornar o HTML.
Sim. O Scrapestack inclui resolução automatizada de CAPTCHA que funciona com Google reCAPTCHA, hCaptcha e outros sistemas de desafio comuns.
Qualquer linguagem que possa fazer solicitações HTTP: Python, JavaScript/Node.js, PHP, Ruby, Go, Java, C# e muito mais.
O Scrapestack economiza tempo e dinheiro significativos se você precisar de rotação de proxies, resolução de CAPTCHA e renderização JS. Para tarefas simples de scraping em sites estáticos, construir sua própria solução com requests + Beautiful Soup pode ser mais barato.
A legalidade do web scraping depende do seu caso de uso e jurisdição. Sempre revise os termos de serviço e o robots.txt de um site antes de fazer scraping. O Scrapestack em si é uma ferramenta — como você a usa determina a legalidade.
O Scrapestack é uma API de web scraping confiável e fácil de integrar que resolve as partes mais dolorosas da extração de dados: gerenciamento de proxies, manipulação de CAPTCHA e renderização JavaScript. É uma excelente escolha para desenvolvedores que desejam começar a raspar rapidamente sem construir infraestrutura complexa.
O plano gratuito é generoso o suficiente para testes, e os planos pagos têm preços razoáveis para volumes pequenos a médios. Para necessidades empresariais de alto volume, você pode querer avaliar serviços de proxy dedicados ou plataformas de scraping empresariais.
Se você está procurando uma API direta que simplesmente funciona — e está disposto a lidar com a análise HTML por conta própria — o Scrapestack é um forte concorrente no cenário de web scraping de 2026.
Nota: AdsPower ajuda equipes a comparar e selecionar as melhores ferramentas para fluxos de trabalho de extração de dados e automação.


