
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
O web scraping em 2026 foi muito além de simples requisições HTTP. Sites modernos usam renderização JavaScript, fingerprinting anti-bot e limitação agressiva de requisições. Um pipeline de dados confiável agora exige uma solução de scraping completa — não apenas uma lista de proxies. Esta classificação avalia 10 APIs genuínas de web scraping e plataformas de coleta de dados que lidam com toda a cadeia de extração: rotação de proxy, resolução de CAPTCHA, fingerprinting de navegador e entrega de dados estruturados.
Nossa análise se baseia em dois benchmarks independentes de terceiros (teste de 11 provedores do Scrape.do e Relatório de API de Web Scraping 2025 da Proxyway), bem como em testes práticos da equipe AdsPower. Avaliamos taxas de sucesso, renderização JavaScript, bypass anti-bot, modelos de preços, experiência do desenvolvedor e prontidão empresarial. Nenhum fornecedor pagou pela inclusão; cada produto é classificado por sua utilidade geral para coleta de dados no mundo real.
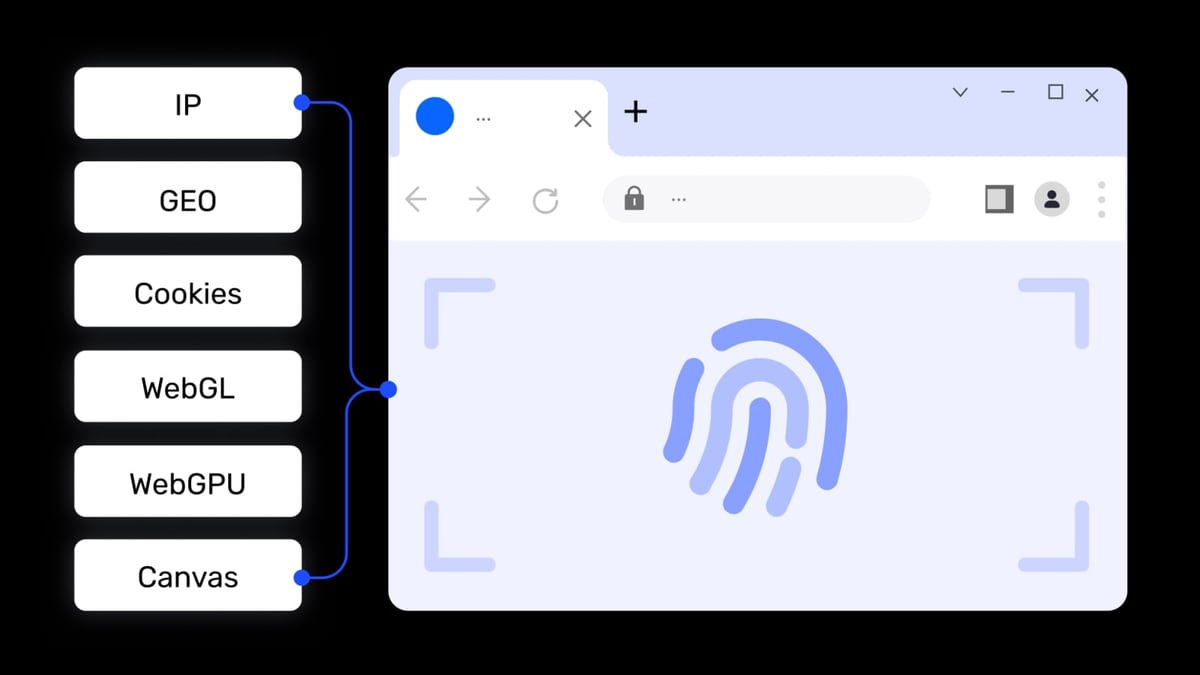
Se você precisa de uma ferramenta complementar para gerenciamento de múltiplas contas ao fazer scraping de plataformas como redes sociais ou Ticketmaster, um navegador anti-detecção como o AdsPower pode isolar fingerprints do navegador e evitar bloqueios. (Veja nosso guia sobre como usar o AdsPower com o Ticketmaster para scraping seguro de múltiplas contas.) No entanto, o AdsPower não é uma API de web scraping e, portanto, não aparece nesta lista dos 10 melhores.
Visão geral da interface e recursos dos produtos Top 10 APIs de Web Scraping e Plataformas de Coleta de Dados em 2026.
Pontuamos cada provedor em oito dimensões que importam após a primeira requisição bem-sucedida:
A classificação sintetiza dados de benchmarks do teste independente do Scrape.do e do relatório de 2025 da Proxyway, além de nossas próprias provas em sites como Amazon, Zillow e Indeed. Os provedores são ordenados pela confiabilidade geral, não por uma única métrica.
Visão geral da interface e recursos dos produtos Top 10 APIs de Web Scraping e Plataformas de Coleta de Dados em 2026.
Veredicto: O padrão ouro empresarial, com a maior taxa de sucesso em benchmarks independentes e o conjunto de recursos mais completo.
A Bright Data opera a maior rede de proxy (mais de 400M de IPs residenciais em 195 países) e a envolve em uma API de Web Scraping que lida com tudo, desde renderização JavaScript até entrega estruturada em JSON. No benchmark de 2026 do Scrape.do, a Bright Data alcançou uma taxa de sucesso média de 98,44% em sete domínios exigentes, atingindo 100% em Indeed, Zillow, Capterra e Google simultaneamente.
Pontos fortes:
Ideal para: Pipelines de dados empresariais, conjuntos de dados para treinamento de IA, monitoramento de preços de e-commerce e qualquer carga de trabalho onde uma raspagem malsucedida tem custo downstream.
Veredicto: Uma API otimizada para latência em projetos onde velocidade e preço previsível por requisição são inegociáveis.
O Scrape.do entregou uma taxa de sucesso média de 98,19% no mesmo benchmark, com respostas do Google chegando em apenas 1,6 segundos e do GitHub em 2,6 segundos. A média combinada ficou abaixo de 5 segundos, tornando-o uma ótima escolha para casos de uso sensíveis ao tempo, como painéis de preços em tempo real ou alertas de inteligência competitiva.
Seu design de endpoint único mantém a integração simples: você envia uma URL, define parâmetros como render=true ou output=markdown e recebe dados limpos. Com mais de 110M de IPs e roteamento geográfico integrado, cobre a maioria dos cenários comuns de scraping sem configuração pesada.
Ideal para: Cargas de trabalho sensíveis à velocidade, monitoramento em tempo real e equipes que priorizam um modelo de custo fixo por requisição.
Veredicto: A plataforma ideal para desenvolvedores que precisam de extração automática e consciente de esquemas de sites complexos e pesados em JavaScript.
A Zyte (antiga Scrapinghub) combina uma API de scraping gerenciada com um ecossistema maduro construído em torno do Scrapy. Seu Smart Crawler e Zyte API renderizam páginas automaticamente, extraem dados estruturados e se adaptam a mudanças de layout. A plataforma se destaca quando sua equipe já usa Scrapy ou precisa de saída JSON limpa sem escrever parsers personalizados.
Para um mergulho profundo nas capacidades da Zyte, leia nossa análise baseada em evidências da Zyte cobrindo API, rotação de proxy e extração por IA.
Ideal para: Equipes Scrapy, pipelines de dados de IA/ML e crawlers de longa duração que exigem confiabilidade.
Veredicto: Um poderoso conjunto de proxies e scrapers para organizações que precisam de escala massiva e controle refinado.
A Oxylabs oferece um pool de mais de 100M de IPs (residenciais, móveis, datacenter) juntamente com APIs SERP dedicadas, scrapers de e-commerce e um Web Scraper IDE. Oferece suporte a evasão de bloqueios orientada por IA e pode lidar com bilhões de requisições mensais para empresas Fortune 500. Embora não seja um serviço totalmente gerenciado por padrão, fornece às equipes de engenharia interna os blocos de construção para criar pipelines de dados resilientes e de alta taxa de transferência.
Ideal para: Inteligência de preços em larga escala, monitoramento de mecanismos de busca e equipes que possuem sua própria infraestrutura de scraping.
Veredicto: Proxies acessíveis e ferramentas de scraping diretas para equipes que ainda não precisam do poder de fogo do nível empresarial.
A API de scraping Decodo da Smartproxy oferece uma taxa de sucesso sólida em sites moderadamente protegidos a um preço acessível. Seus proxies residenciais, móveis e de datacenter cobrem mais de 195 locais, e o painel simples torna a integração rápida. O ponto ideal é o monitoramento de e-commerce de pequeno a médio porte, rastreamento de classificação de SEO e pesquisa de mercado.
Ideal para: Agências, equipes de dados em crescimento e projetos com orçamento limitado que ainda precisam de segmentação geográfica confiável.
Veredicto: Uma API amigável ao desenvolvedor que elimina a dor de cabeça do gerenciamento de proxy e renderização JavaScript para trabalhos de scraping diretos.
A API do ScrapingBee aceita uma URL e retorna HTML renderizado, com suporte opcional para proxies premium e extração com IA. A documentação é clara, os SDKs são abundantes e o sistema de crédito pré-pago escala facilmente de projetos pessoais para tarefas de produção de volume médio. No entanto, não iguala a capacidade de desbloqueio dos provedores de primeira linha em sites fortemente protegidos.
Ideal para: Ferramentas internas, MVPs e equipes que querem uma API de scraping rápida para implementar sem gerenciar infraestrutura.
Veredicto: Uma API fácil de integrar para scraping de alto volume de sites desprotegidos ou levemente protegidos.
O ScraperAPI gira IPs automaticamente, lida com CAPTCHAs e retorna HTML ou JSON estruturado. Seu plano gratuito e preços escaláveis o tornam um favorito entre startups e pequenas empresas que constroem ferramentas de dados internas. No entanto, as taxas de sucesso caem drasticamente em sites protegidos por sistemas anti-bot avançados, como o JS Challenge da Cloudflare. Nossa avaliação do ScraperAPI está alinhada com a comparação dos melhores serviços de web scraping da Datahut, que observa que sua força é a simplicidade, não alvos fortemente defendidos.
Ideal para: Prototipagem rápida, coleta de dados de baixa complexidade e equipes que priorizam uma configuração de baixo atrito.
Veredicto: Uma API de scraping projetada especificamente para contornar as defesas anti-bot mais difíceis, incluindo Cloudflare, DataDome e PerimeterX.
O ZenRows usa evasão avançada de fingerprinting de navegador e lógica de repetição automática. Ele brilha em alvos que fazem outras APIs falharem com páginas em branco ou telas de desafio. A desvantagem é um custo por requisição mais alto e uma curva de aprendizado mais íngreme para configuração. No entanto, para equipes que precisam extrair dados de sites bloqueados, o prêmio se justifica.
Ideal para: Scraping de domínios fortemente protegidos onde APIs padrão e listas de proxy falham.
Verdicto: Uma plataforma única que transforma o scraping em “Atores” reutilizáveis que você pode construir, compartilhar ou comprar.
O Apify combina automação de navegador, crawling e transformação de dados em um único fluxo de trabalho. Dezenas de milhares de Atores pré-construídos cobrem tarefas como extração de hashtags do Instagram, rastreamento de produtos da Amazon e arquivamento da web. Embora não seja uma API de scraping pura (muitas vezes você executa um Ator em vez de disparar uma única URL), sua versatilidade o torna um complemento poderoso para APIs gerenciadas tradicionais.
Ideal para: Equipes que precisam de fluxos de trabalho em várias etapas (login → busca → paginação → extração) ou desejam construir automações internas de scraping sem reinventar a roda.
Veredicto: Um serviço de coleta de dados com atendimento personalizado que entrega conjuntos de dados sob medida, não HTML bruto ou APIs.
A Datahut constrói e mantém pipelines de extração personalizados para cada cliente, o que proporciona maior precisão e melhor conformidade em sites complexos e dinâmicos. Como não há API pública para bots fazerem engenharia reversa, os pipelines são mais difíceis de detectar e bloquear. Empresas que desejam zero custo indireto de engenharia e entrega garantida devem considerar a Datahut, embora exija um projeto com escopo definido e não seja adequada para pequenos experimentos.
Ideal para: Empresas Fortune 500, marketplaces de e-commerce e equipes de IA que precisam de conjuntos de dados confiáveis e contínuos sem construir uma equipe interna de scraping.
Visão geral da interface e recursos dos produtos Top 10 APIs de Web Scraping e Plataformas de Coleta de Dados em 2026.
| Ferramenta | Ideal Para | Referência de Taxa de Sucesso | Renderização JS | Pagamento por Sucesso | Serviço Gerenciado |
|---|---|---|---|---|---|
| Bright Data | Escala empresarial, sites protegidos | 98,44% média (teste Scrape.do) | Sim | Sim | Não (mas pilha completa) |
| Scrape.do | Baixa latência, trabalhos sensíveis à velocidade | 98,19% média | Sim | Fixo por requisição | Não |
| Zyte | Usuários do Scrapy, extração por IA | Não avaliado (proprietário) | Sim | Sim (via planos gerenciados) | Opcional |
| Oxylabs | Grandes redes de proxy, alta taxa de transferência | Não testado independentemente | Sim | Planos personalizados | Não |
| Smartproxy (Decodo) | Custo-benefício para o mercado médio | Moderado (não testado aqui) | Sim | Depende do plano | Não |
| ScrapingBee | Scraping simples e rápido | Não testado independentemente | Sim | Baseado em créditos | Não |
| ScraperAPI | Orçamento, sites desprotegidos | Mais baixo em sites Cloudflare | Sim (créditos extras) | Planos de assinatura fixa | Não |
| ZenRows | Alvos anti-bot mais difíceis | Não avaliado | Sim | Por requisição | Não |
| Apify | Fluxos de trabalho de navegador em várias etapas | Não avaliado (dependente do Ator) | Sim | Preço dependente do Ator | Não |
| Datahut | Entrega empresarial totalmente gerenciada | Quase 100% em pipelines personalizados | Sim (gerenciado) | Por projeto | Sim |
Visão geral da interface e recursos dos produtos Top 10 APIs de Web Scraping e Plataformas de Coleta de Dados em 2026.
Escolher uma API de web scraping não é uma decisão única para todos. Comece perguntando:
Uma observação sobre fluxos de trabalho complementares: ao fazer scraping de plataformas que impõem limites estritos de conta (redes sociais, mercados de ingressos), executar vários perfis de navegador isolados evita bloqueios de conta. Navegadores anti-detecção como o AdsPower criam fingerprints digitais separados e combinam bem com sua API de scraping. Confira nosso guia sobre como usar o AdsPower para configuração de múltiplas contas no Ticketmaster para ver como essa combinação funciona na prática.
Uma API de web scraping é um serviço hospedado que automatiza todo o processo de extração de dados. Você envia uma URL de destino; a API lida com seleção de proxy, resolução de CAPTCHA, renderização JavaScript e bypass anti-bot, e retorna dados limpos (HTML, JSON, CSV). Isso elimina a necessidade de construir e manter sua própria infraestrutura de scraping.
De acordo com vários benchmarks independentes em 2025-2026, a Bright Data detém a maior taxa de sucesso média documentada — 98,44% em um conjunto de sete domínios difíceis.
Várias plataformas oferecem planos gratuitos. O ScraperAPI oferece um plano gratuito limitado, e o plano gratuito do Apify inclui créditos de uso mensais. No entanto, serviços totalmente gratuitos geralmente carecem de capacidades anti-bot e falharão em sites modernos protegidos.
Sim. Uma API de scraping é um superconjunto da funcionalidade de proxy. Ela agrupa rotação de proxy, renderização de navegador e lógica de repetição. Para casos de uso simples, apenas um proxy pode ser suficiente, mas para confiabilidade na web de hoje, uma API de scraping completa é a rota mais eficiente.
Uma API de scraping lhe dá acesso programático e deixa a análise e garantia de qualidade para sua equipe. Uma plataforma gerenciada como a Datahut entrega conjuntos de dados prontos, adaptados ao seu esquema, lidando com toda a complexidade técnica e manutenção em seu nome.
O cenário de web scraping em 2026 oferece um espectro que vai de APIs de commodity a plataformas de nível empresarial e serviços de dados totalmente gerenciados. A escolha certa depende de seus recursos técnicos, complexidade do site alvo e requisitos de entrega de dados. Recomendamos testar dois ou três desses provedores classificados em suas URLs de destino reais e monitorar não apenas a taxa de sucesso, mas também o tempo que sua equipe gasta em manutenção e limpeza de dados.
Na AdsPower, avaliamos continuamente ferramentas de infraestrutura de dados para ajudar as equipes a tomar decisões informadas e baseadas em evidências. Use este guia como ponto de partida e sempre execute uma prova de conceito antes de se comprometer com um contrato. O custo de dados ruins — insights perdidos, pipelines quebrados, horas de engenharia desperdiçadas — supera em muito o custo de um parceiro de scraping confiável.


