
AdsPower против ClonBrowser: какой антидетект-браузер лучше?
18 нояб. 2026 г.
Парсинг данных — часто называемый веб-парсингом — это автоматизированный процесс извлечения информации с веб-сайтов и преобразования ее в структурированный, читаемый формат, например, электронную таблицу или базу данных. Будь вы маркетолог, собирающий цены конкурентов, журналист, анализирующий публичные записи, или разработчик, создающий каталог продуктов, парсинг данных экономит тысячи часов ручного копирования и вставки. В AdsPower мы подробно рассказываем все, что вам нужно знать об этом мощном методе, включая то, как его ответственно использовать и как современные антидетект-браузеры, такие как AdsPower, помогают масштабироваться без блокировок.
Что такое парсинг данных? Полное руководство с инструментами и защитой — интерфейс продукта и обзор функций.
Парсинг данных — это использование программного обеспечения для автоматического извлечения контента с веб-страниц. Вместо того чтобы кликать страницу за страницей, парсер отправляет HTTP-запросы, читает ответ и извлекает определенные данные — текст, изображения, цены, email-адреса — в структурированную форму. Существует три основных разновидности:
Люди часто путают парсинг данных с веб-сканированием. Сканер (например, Googlebot) перемещается по всему вебу, переходя по ссылкам и индексируя содержимое страниц, в основном читая код. Парсер, напротив, игнорирует большую часть кода и фокусируется на видимых данных, которые вам нужны — ценах, заголовках, контактных данных — иногда даже игнорируя запросы robots.txt. Эта эффективность также делает парсинг частым предметом злоупотреблений.
Что такое парсинг данных? Полное руководство с инструментами и защитой — интерфейс продукта и обзор функций.
Большинство современных веб-парсеров следуют простому трехэтапному циклу:
Для динамических страниц, загружающих контент через JavaScript, парсеры могут встраивать headless-браузер (например, Puppeteer или Playwright) для полной визуализации страницы перед извлечением. Этот подход делает парсер неотличимым от обычного посетителя — если только отпечаток браузера не выдаст его.
Что такое парсинг данных? Полное руководство с инструментами и защитой — интерфейс продукта и обзор функций.
Парсеры бывают разных видов, от одношаговых браузерных расширений до пользовательских сценариев на Python. Основные методы включают:
IMPORTXML, IMPORTHTML и REGEXEXTRACT позволяют любому извлечь данные из URL прямо в электронную таблицу без программирования.Специализированные инструменты, такие как Scrapingdog (полностью управляемый API), браузерные расширения типа Data Scraper или Data Miner, а также фреймворки автоматизации Selenium, Puppeteer и Playwright дают разработчикам полный контроль. Для детального сравнения ведущих библиотек ознакомьтесь с нашим руководством Топ-10 библиотек автоматизации браузера в 2026.
Что такое парсинг данных? Полное руководство с инструментами и защитой — интерфейс продукта и обзор функций.
При этичном использовании парсинг данных питает целые отрасли. Распространенные законные варианты применения:
Все эти действия предполагают, что парсер соблюдает условия использования источника, ограничения скорости и законы о конфиденциальности, такие как GDPR или CCPA.
Злоумышленники злоупотребляют той же технологией для:
Громкие дела, такие как иск Facebook к компаниям в 2020 году за сбор пользовательских данных через вредоносные расширения, показывают, как парсинг может превратиться из инструмента в оружие. Законность также варьируется: в некоторых юрисдикциях автоматический сбор email-адресов полностью запрещен, а парсинг за страницей входа почти всегда нарушает Закон о компьютерном мошенничестве и злоупотреблениях в США.
Поскольку любые данные, видимые пользователю, также видны парсеру, идеальной защиты не существует. Однако эти четыре уровня значительно повышают планку:
Для защиты корпоративного уровня такие решения, как Advanced Bot Protection от Imperva, сочетают машинное обучение, поведенческий анализ и механизмы запрос-ответ, чтобы блокировать парсеров до их подключения.
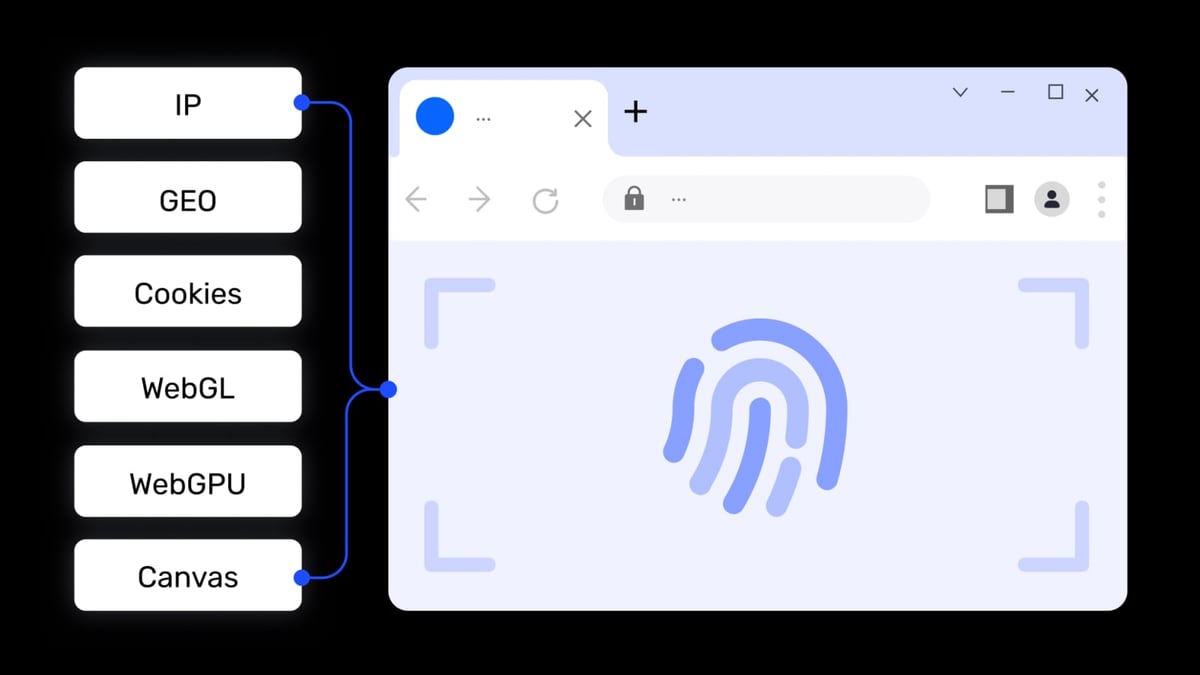
Когда вы выходите за рамки одного извлечения в таблицу и начинаете масштабный парсинг, вы быстро сталкиваетесь со стеной: веб-сайты активно снимают отпечатки вашего браузера, чтобы обнаружить автоматизацию. Они проверяют хеши Canvas, строки рендерера WebGL, обработку аудио и даже ваш список шрифтов. Если сотни запросов приходят с одного и того же отпечатка, IP блокируется — или, что еще хуже, цель вводит постоянный бан.
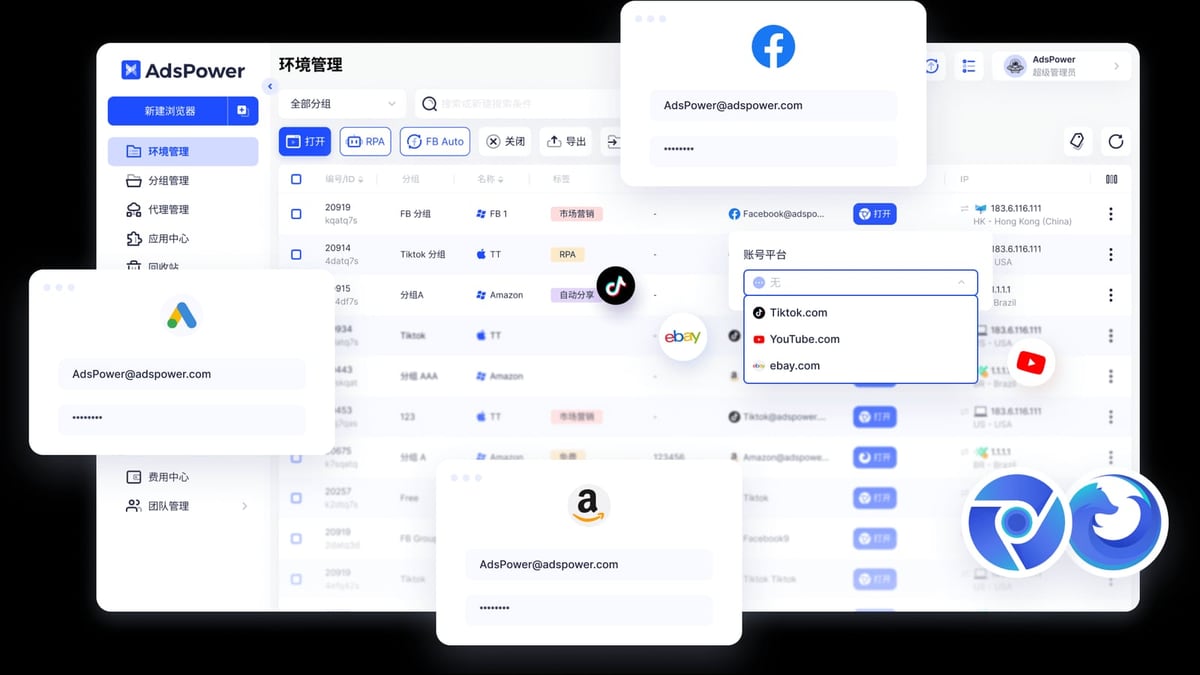
Вот тут и становится незаменимым антидетект-браузер. AdsPower — это профессиональный браузер с цифровыми отпечатками, который создает изолированные браузерные среды, каждая с уникальной постоянной цифровой идентификацией. Вы можете настроить более 20 параметров отпечатков (Canvas, WebGL, AudioContext, WebRTC), так что каждый профиль парсера выглядит как отдельный реальный пользователь на другом устройстве. Для команд по парсингу данных AdsPower предлагает:
Комбинируя AdsPower с надежной прокси-сетью, вы сводите риск обнаружения почти к нулю. Для детального сравнения антидетект-браузеров прочитайте наше Сравнение AdsPower vs RoxyBrowser vs Kameleo.
Как правило, сбор общедоступных данных, не требующих входа в систему, законен во многих странах при условии соблюдения авторских прав, условий использования и законов о защите данных. Всегда консультируйтесь с юристом для вашего конкретного случая.
Веб-парсинг — это подмножество парсинга данных, которое фокусируется исключительно на веб-сайтах. Парсинг данных также может включать экраны устаревших систем, PDF-файлы или другие цифровые источники.
Да. Браузерные расширения, такие как Data Miner, и встроенные функции Google Таблиц (IMPORTXML) позволяют непрограммистам легко извлекать данные. Для продвинутых нужд платформы без кода и RPA-инструменты внутри AdsPower упрощают процесс.
Чередуйте IP-адреса с помощью прокси, расставляйте запросы по времени, рандомизируйте строки user-agent и используйте антидетект-браузер, такой как AdsPower, для поддержания уникальных отпечатков. Также уважайте robots.txt и внедряйте вежливые задержки.
Резидентные и ISP-прокси обеспечивают наибольшее доверие. Для использования в многопрофильных аккаунтах и парсинге ознакомьтесь с нашим Обзором Proxy-Seller для объективного взгляда на реальную производительность.
Парсинг данных — это палка о двух концах. В правильных руках он питает исследования, автоматизацию и конкурентную разведку. В неправильных — вторгается в частную жизнь и крадет контент. Ключ в том, чтобы использовать правильные инструменты, соблюдать границы и защищать свои собственные активы от злоупотреблений. Начинаете ли вы с Google Таблиц или проектируете высокообъемный конвейер парсинга, понимание основных методов — и защиты на уровне отпечатков от обнаружения — необходимо. Для более глубоких сравнений, обзоров и стратегий автоматизации изучите ресурсы здесь, на AdsPower.


