
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
Data scraping — frequentemente chamado de web scraping — é o processo automatizado de extrair informações de sites e transformá-las em um formato estruturado e legível por humanos, como uma planilha ou banco de dados. Seja você um profissional de marketing coletando preços de concorrentes, um jornalista analisando registros públicos ou um desenvolvedor construindo um catálogo de produtos, o data scraping economiza milhares de horas de cópia e colagem manuais. Na AdsPower, detalhamos tudo o que você precisa saber sobre essa técnica poderosa, incluindo como usá-la de forma responsável e como navegadores modernos anti-detecção como o AdsPower ajudam você a escalar sem ser bloqueado.
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
Data scraping é o uso de software para extrair conteúdo de páginas web automaticamente. Em vez de clicar página após página, um scraper envia requisições HTTP, lê a resposta e extrai pontos de dados específicos — texto, imagens, preços, e-mails — para um formato estruturado. Existem três tipos principais:
As pessoas frequentemente confundem data scraping com rastreamento web (web crawling). Um rastreador (como o Googlebot) navega por toda a web, seguindo links e indexando o conteúdo das páginas principalmente lendo o código. Um scraper, por outro lado, ignora a maior parte do código e foca nos dados visíveis que você deseja — preços, manchetes, detalhes de contato — até ignorando solicitações robots.txt em alguns casos. Essa eficácia também faz do scraping um assunto frequente de uso indevido.
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
A maioria dos scrapers web modernos segue um ciclo simples de três etapas:
Para páginas dinâmicas que carregam conteúdo via JavaScript, os scrapers podem incorporar um navegador headless (como Puppeteer ou Playwright) para renderizar a página completamente antes da extração. Essa abordagem torna o scraper indistinguível de um visitante normal — desde que a impressão digital do navegador não o denuncie.
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
Os scrapers vêm em todas as formas, desde extensões de navegador com um clique até scripts Python personalizados. As principais técnicas incluem:
IMPORTXML, IMPORTHTML e REGEXEXTRACT permitem que qualquer pessoa extraia dados de uma URL diretamente para uma planilha sem programação.Ferramentas dedicadas como Scrapingdog (uma API totalmente gerenciada), extensões de navegador como Data Scraper ou Data Miner, e frameworks de automação como Selenium, Puppeteer e Playwright dão aos desenvolvedores controle total. Para uma comparação direta das principais bibliotecas, veja nosso guia Top 10 Bibliotecas de Automação de Navegador em 2026.
Interface do produto e visão geral dos recursos do Guia Completo de Data Scraping com Ferramentas e Proteção.
Quando usado eticamente, o data scraping alimenta indústrias inteiras. Casos de uso legítimos comuns:
Todas essas atividades pressupõem que o scraper respeite os termos de serviço da fonte, limites de taxa e regulamentações de privacidade como GDPR ou CCPA.
Atores mal-intencionados abusam da mesma tecnologia para:
Casos de alto perfil, como o Facebook processando empresas em 2020 por scraping de dados de usuários através de extensões maliciosas, mostram como o scraping pode passar de ferramenta a arma. A legalidade também varia: algumas jurisdições proíbem completamente a coleta automatizada de e-mails, e o scraping atrás de uma barreira de login quase sempre viola o Computer Fraud and Abuse Act nos EUA.
Como qualquer dado visível a um usuário também é visível a um scraper, nenhuma defesa é perfeita. No entanto, essas quatro camadas elevam significativamente a barreira:
Para proteção de nível empresarial, soluções como a Proteção Avançada contra Bots da Imperva combinam aprendizado de máquina, análise comportamental e mecanismos de desafio-resposta para bloquear scrapers antes mesmo de se conectarem.
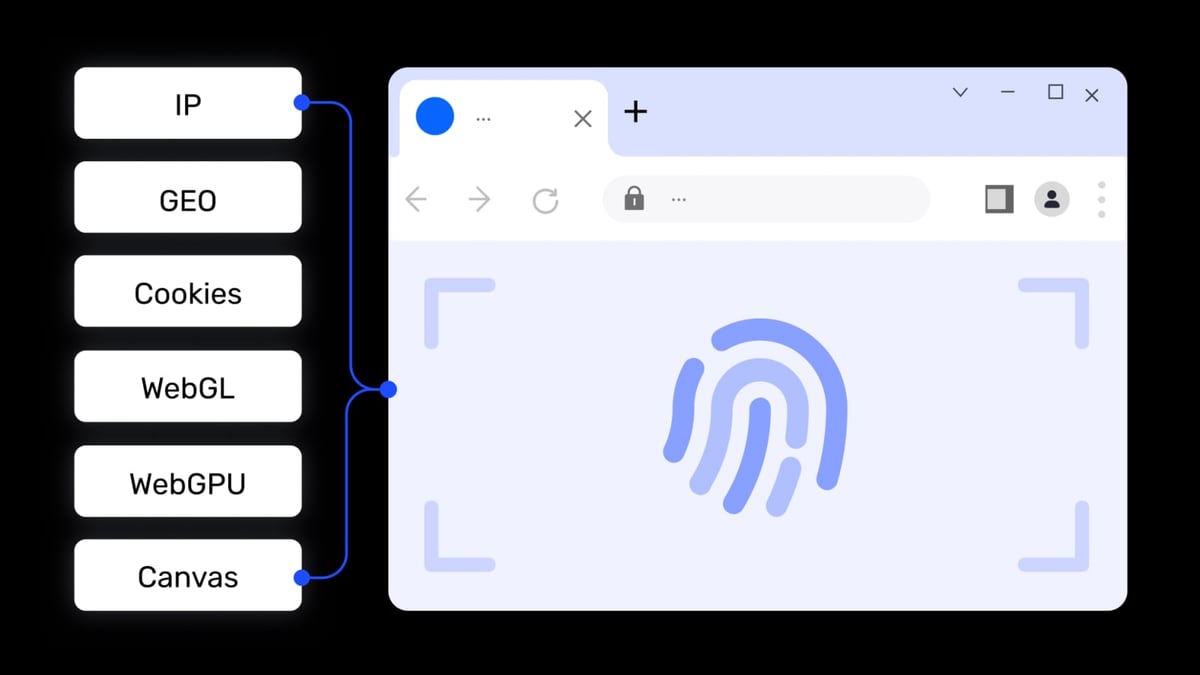
Quando você vai além de uma única extração de planilha e começa a fazer scraping em larga escala, rapidamente encontra um obstáculo: os sites ativamente identificam a impressão digital do seu navegador para detectar automação. Eles verificam hashes de Canvas, strings do renderizador WebGL, processamento de áudio e até sua lista de fontes. Se cem requisições vierem da mesma impressão digital, o IP é bloqueado — ou pior, o alvo introduz um banimento persistente.
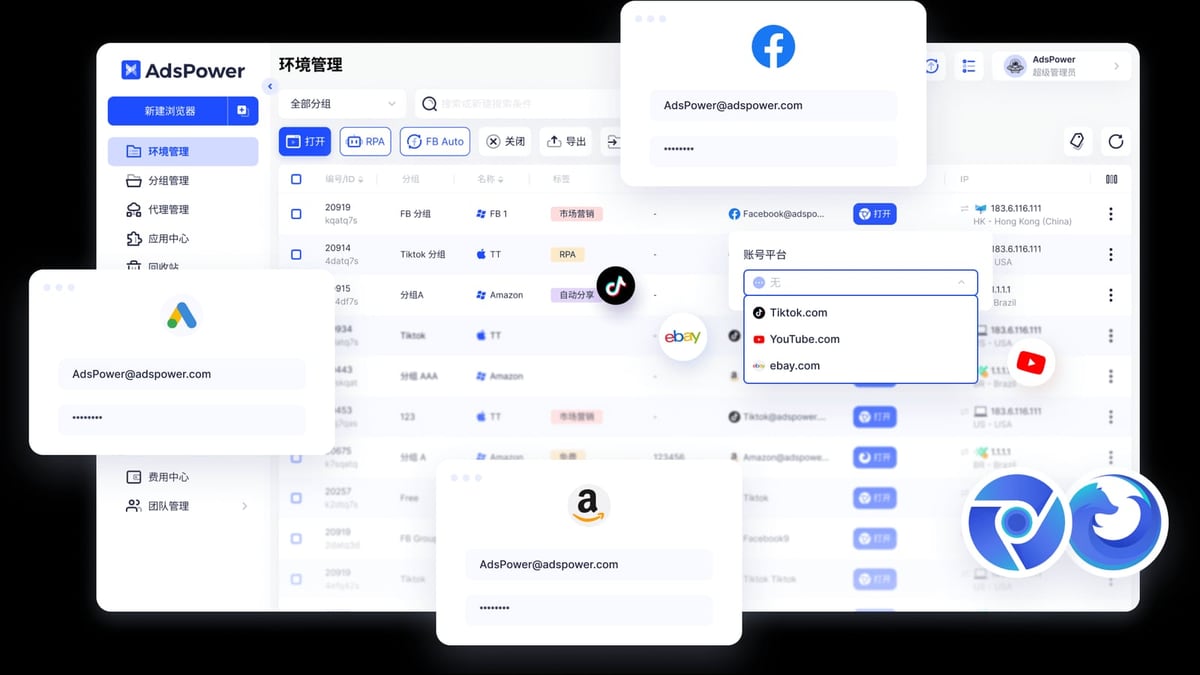
É aí que um navegador anti-detecção se torna essencial. AdsPower é um navegador profissional de impressão digital que cria ambientes de navegador isolados, cada um com uma identidade digital única e persistente. Você pode personalizar mais de 20 parâmetros de impressão digital (Canvas, WebGL, AudioContext, WebRTC) para que cada perfil de scraper pareça um usuário real distinto em um dispositivo diferente. Para equipes de data scraping, o AdsPower oferece:
Ao combinar o AdsPower com uma rede de proxies confiável, você reduz o risco de detecção para quase zero. Para uma comparação detalhada de navegadores anti-detecção, leia nossa Comparação AdsPower vs RoxyBrowser vs Kameleo.
Geralmente, extrair dados publicamente acessíveis que não exigem login é legal em muitos países, desde que você respeite direitos autorais, termos de serviço e leis de proteção de dados. Sempre consulte um profissional jurídico para o seu caso específico.
Web scraping é um subconjunto do data scraping que se concentra exclusivamente em sites. Data scraping também pode envolver telas de sistemas legados, PDFs ou outras fontes digitais.
Sim. Extensões de navegador como Data Miner e funções internas do Google Planilhas (IMPORTXML) permitem que não programadores extraiam dados facilmente. Para necessidades avançadas, plataformas sem código e ferramentas RPA dentro do AdsPower simplificam o processo.
Rotacione IPs usando proxies, espaçe as requisições, randomize strings de user-agent e use um navegador anti-detecção como o AdsPower para manter impressões digitais únicas. Além disso, respeite o robots.txt e implemente atrasos educados.
Proxies residenciais e de ISP oferecem a maior confiança. Para casos de uso de multi-contas e scraping, confira nossa Análise do Proxy-Seller para uma visão honesta do desempenho no mundo real.
Data scraping é uma faca de dois gumes. Nas mãos certas, ele impulsiona pesquisa, automação e inteligência competitiva. Nas erradas, invade a privacidade e rouba conteúdo. A chave é usar as ferramentas certas, respeitar limites e proteger seus próprios ativos contra abusos. Quer você esteja começando com o Google Planilhas ou projetando um pipeline de scraping de alto volume, entender as técnicas principais — e as defesas em nível de impressão digital contra detecção — é essencial. Para comparações mais aprofundadas, análises e estratégias de automação, explore os recursos aqui na AdsPower.


