
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
O web scraping é essencial para pesquisa de mercado, monitoramento de preços e geração de leads. Mas os sites modernos contra-atacam com bloqueios de IP, CAPTCHAs e impressão digital do navegador. É aí que entram o AdsPower (um navegador anti-detecção profissional) e o Beautiful Soup (uma biblioteca Python de análise de HTML). Este guia mostra como combinar essas ferramentas para fluxos de trabalho de scraping anônimos, escaláveis e sustentáveis.
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
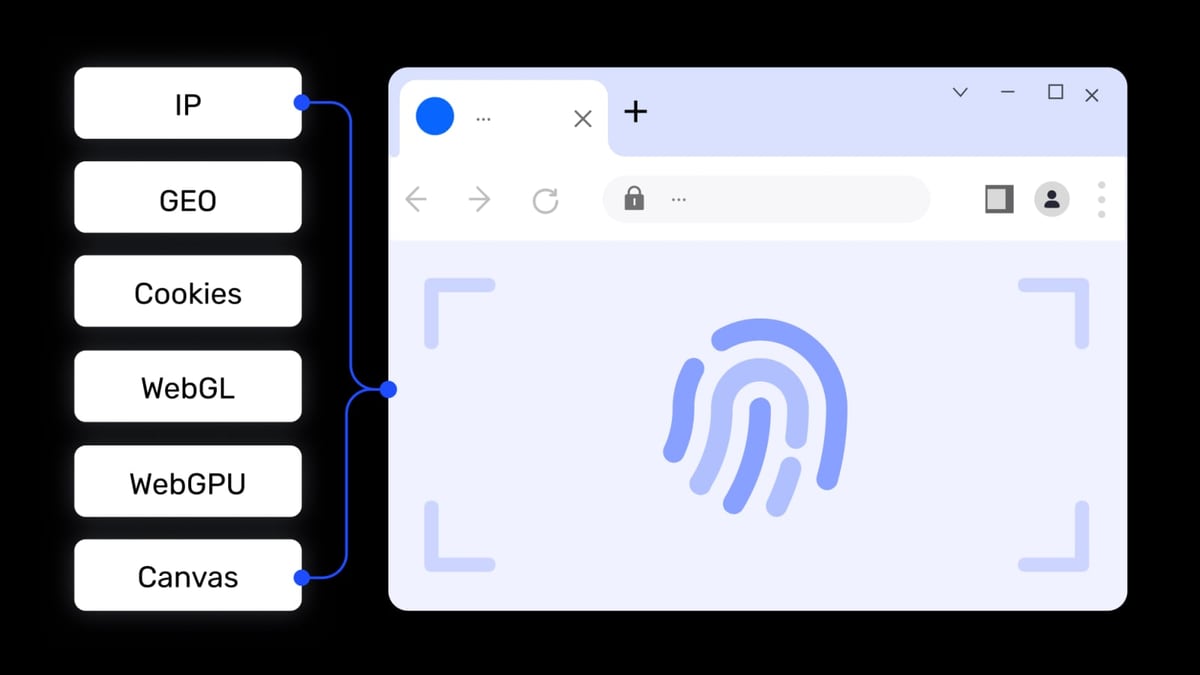
O AdsPower cria ambientes de navegador isolados com impressões digitais digitais únicas. Ele permite gerenciar várias contas ou sessões de scraping sem ser detectado. O Beautiful Soup, por outro lado, é a biblioteca Python preferida para extrair dados estruturados de HTML e XML. Juntos, eles resolvem dois problemas centrais:
Essa combinação é ideal para vendedores de comércio eletrônico transfronteiriço, profissionais de marketing de afiliados e analistas de dados que precisam raspar plataformas como Amazon, Facebook ou Google sem acionar bloqueios.
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
requests, beautifulsoup4 e selenium instalados.Abra o AdsPower e clique em Novo Navegador. Configure:
Após a criação, anote o ID do Ambiente (uma string hexadecimal de 32 caracteres) – você precisará dele para a API.
O AdsPower fornece uma API REST para abrir janelas do navegador. Use este script Python para iniciar um ambiente:
import requests
import json

# Endpoint da API Local do AdsPower
url = "http://local.adspower.net:50325/api/v1/browser/start"

# Seu ID de ambiente
env_id = "SEU_ID_DE_AMBIENTE"

params = {
    "user_id": env_id,
    "open_urls": "https://example.com"  # opcional
}

response = requests.get(url, params=params)
data = response.json()

if data["code"] == 0:
    print("Navegador iniciado com sucesso")
    print("URL do depurador WebSocket:", data["data"]["ws"]["selenium"])
else:
    print("Erro:", data["msg"])
O AdsPower retorna uma URL do depurador WebSocket que você pode usar com o driver Remote do Selenium:
from selenium import webdriver
from selenium.webdriver.chrome.options import Options

chrome_options = Options()
chrome_options.add_experimental_option("debuggerAddress", "127.0.0.1:9222")  # porta da resposta da API

driver = webdriver.Chrome(options=chrome_options)
driver.get("https://example.com")
Nota: A porta exata é fornecida na resposta da API em
data.data.ws.selenium. Pode ser necessário analisá-la.
Assim que a página carregar, pegue o HTML e deixe o Beautiful Soup fazer sua mágica:
from bs4 import BeautifulSoup

html = driver.page_source
soup = BeautifulSoup(html, "html.parser")

# Exemplo: extrair todos os títulos de produtos
titles = soup.find_all("h2", class_="product-title")
for title in titles:
    print(title.get_text(strip=True))
Sempre feche o navegador para liberar recursos:
requests.get("http://local.adspower.net:50325/api/v1/browser/stop", params={"user_id": env_id})
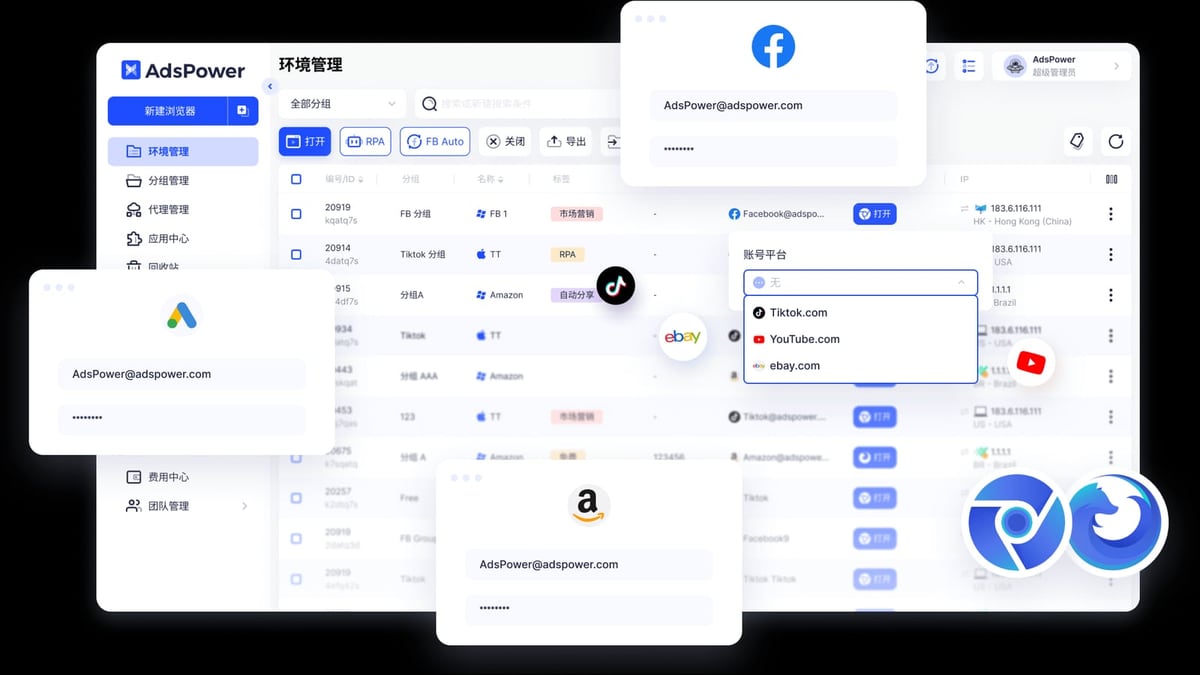
Interface do produto e visão geral dos recursos do AdsPower + Beautiful Soup: Guia de Web Scraping 2026.
Digamos que você queira monitorar preços em um site de comércio eletrônico. Aqui está um script completo que usa o AdsPower para anonimato e o Beautiful Soup para análise:
import requests
from selenium import webdriver
from bs4 import BeautifulSoup

# Iniciar ambiente AdsPower
env_id = "abc123..."
start_resp = requests.get("http://local.adspower.net:50325/api/v1/browser/start",
                          params={"user_id": env_id, "open_urls": "https://shop.example.com/products"})
data = start_resp.json()

# Conectar Selenium
debugger_url = data["data"]["ws"]["selenium"]
chrome_options = webdriver.ChromeOptions()
chrome_options.add_experimental_option("debuggerAddress", debugger_url.split(":")[-1])
driver = webdriver.Chrome(options=chrome_options)

# Aguardar carregamento da página (use esperas explícitas em produção)
import time
time.sleep(3)

# Analisar com Beautiful Soup
soup = BeautifulSoup(driver.page_source, "html.parser")
prices = []
for item in soup.select(".product-card"):
    name = item.find("h3").get_text(strip=True)
    price = item.find("span", class_="price").get_text(strip=True)
    prices.append({"name": name, "price": price})

print(prices)

# Limpeza
driver.quit()
requests.get("http://local.adspower.net:50325/api/v1/browser/stop", params={"user_id": env_id})
O AdsPower permite criar centenas de ambientes, cada um com uma impressão digital e proxy únicos. Para raspar em escala:
Exemplo de trecho usando concurrent.futures:
from concurrent.futures import ThreadPoolExecutor

def scrape_env(env_id, proxy, url):
    # Iniciar, raspar, analisar, fechar
    pass

with ThreadPoolExecutor(max_workers=5) as executor:
    executor.map(scrape_env, env_ids, proxies, urls)
| Problema | Solução |
|---|---|
| A API do AdsPower retorna "porta já em uso" | Feche ambientes não utilizados ou aumente o intervalo de portas nas configurações do AdsPower. |
| Beautiful Soup não encontra elementos | Verifique se o conteúdo é carregado via JavaScript. Use WebDriverWait do Selenium antes de analisar. |
| Sites ainda bloqueiam requisições | Certifique-se de que seu proxy está limpo e não está na lista negra. Considere rotacionar proxies por ambiente. |
| Incompatibilidade de versão do driver Selenium | Corresponda a versão do ChromeDriver à versão do Chromium usada pelo AdsPower (SunBrowser). |
Sim, se a página alvo for estática. Você pode usar requests dentro do ambiente AdsPower configurando o mesmo proxy e user-agent. No entanto, a maioria dos sites modernos requer renderização JavaScript, então o Selenium é recomendado.
O plano gratuito inclui 2 ambientes de navegador. Para scraping em pequena escala, é suficiente. Para projetos maiores, considere um plano pago que suporte mais ambientes e colaboração em equipe.
Com certeza. A API Local do AdsPower também retorna URLs WebSocket compatíveis com Playwright e Puppeteer. A mesma lógica do Beautiful Soup se aplica.
O isolamento de impressão digital do AdsPower reduz os acionamentos de CAPTCHA, mas você ainda pode encontrá-los. Integre um serviço de resolução de CAPTCHA (por exemplo, 2Captcha) no seu fluxo Selenium.
Combinar AdsPower com Beautiful Soup oferece uma pilha de web scraping poderosa e anônima. O AdsPower lida com a diversidade de impressões digitais e gerenciamento de proxy, enquanto o Beautiful Soup torna a análise de HTML muito fácil. Seja raspando dados de produtos, monitorando concorrentes ou agregando leads, essa dupla permite escalar sem ser bloqueado.
Comece com o plano gratuito do AdsPower, experimente os exemplos de código acima e expanda gradualmente para scraping multi-ambiente. Para mais comparações de navegadores anti-detecção, confira nosso guia AdsPower vs Indigo vs GoLogin ou aprenda como integrar AdsPower com Bright Data para um gerenciamento de proxy ainda melhor.
Feliz scraping – e fique indetectável!


