
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
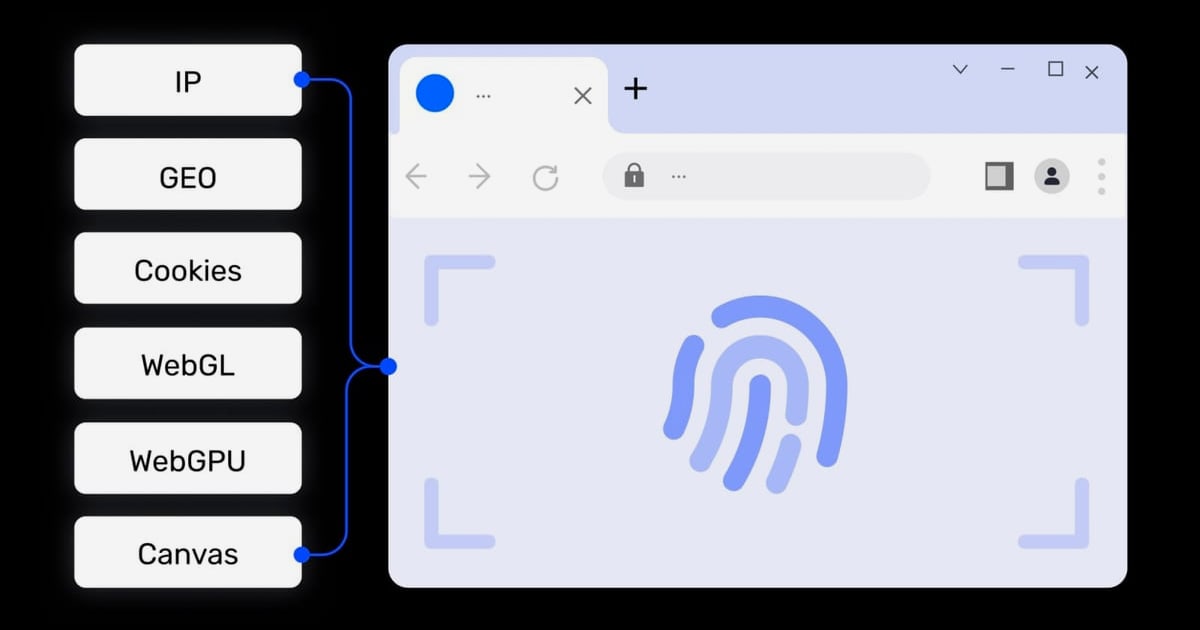
O web scraping em grande escala frequentemente aciona medidas anti-bot que bloqueiam ou identificam seu raspador. Combinar o navegador de impressão digital AdsPower com o Scrapy oferece um pipeline de scraping poderoso e furtivo. O AdsPower fornece ambientes de navegador isolados com impressões digitais únicas, enquanto o Scrapy lida com o rastreamento e extração de dados. Juntos, eles resolvem problemas de associação de contas, bloqueio de IP e detecção de impressão digital do navegador.
Este guia aborda o fluxo de trabalho de integração, etapas de configuração, exemplos práticos de código e os problemas específicos que essa combinação resolve.
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
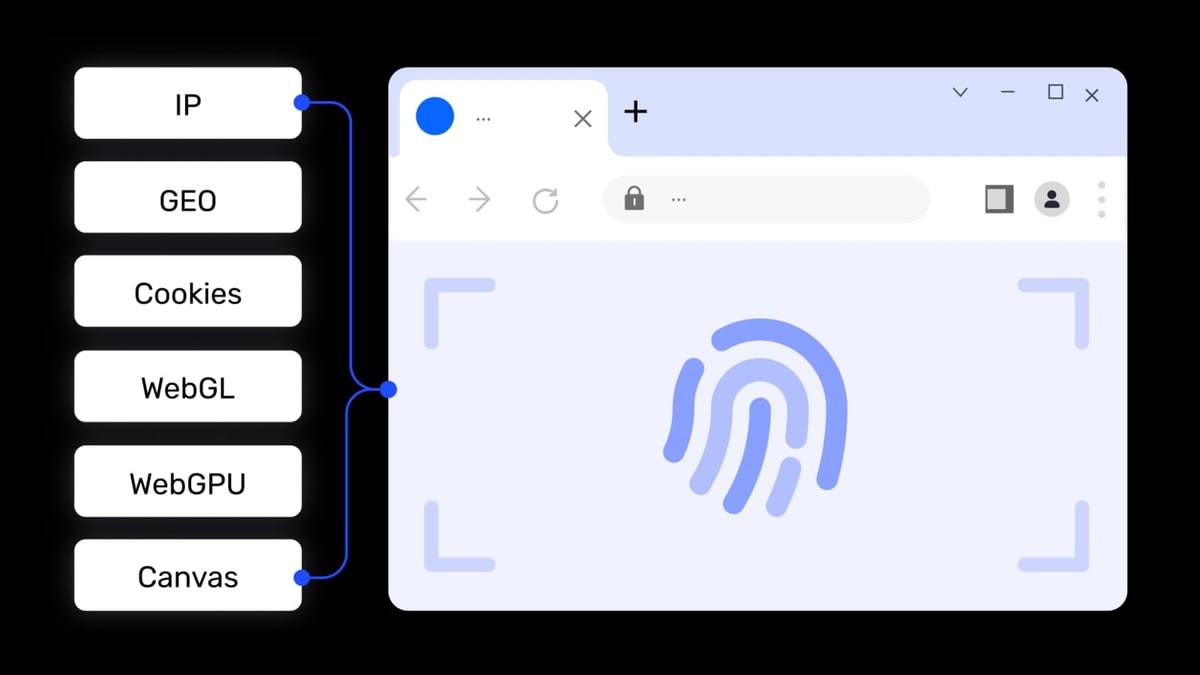
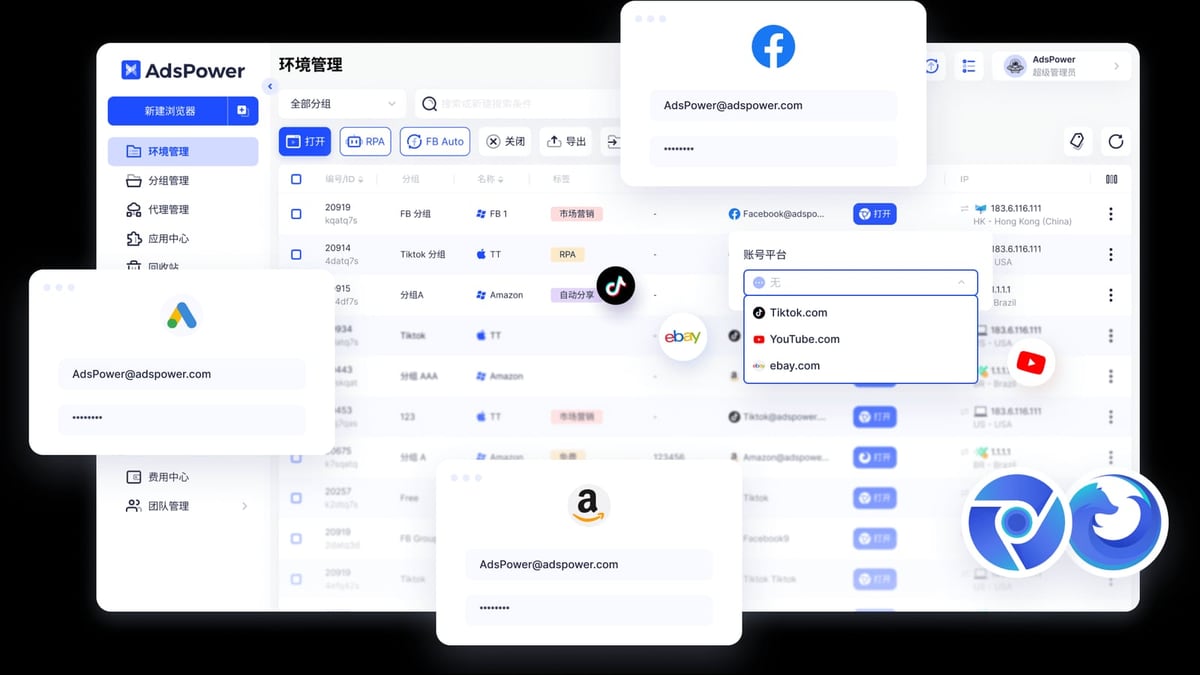
O Scrapy é um framework Python rápido e assíncrono para extrair dados de sites. No entanto, ele usa requisições HTTP brutas por padrão, o que facilita a detecção e bloqueio de raspadores pelos sites. O AdsPower cria ambientes de navegador reais com impressões digitais personalizáveis (Canvas, WebGL, Áudio, WebRTC, etc.), fazendo cada sessão parecer um usuário único em um dispositivo diferente.
Problemas resolvidos por esta combinação:
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
O fluxo de trabalho tem três componentes principais:
Aqui está o fluxo de alto nível:
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
Antes de começar, certifique-se de ter:
pip install scrapypip install requests
Interface do produto e visão geral dos recursos do Como Usar o Navegador de Impressão Digital AdsPower com Scrapy.
Abra o AdsPower, vá em Configurações > API e anote a porta da API (padrão é 50325). Mantenha o cliente AdsPower em execução em segundo plano.
No AdsPower, crie um novo perfil de navegador. Atribua um proxy (HTTP, HTTPS, SOCKS5) se necessário. Anote o user_id do perfil – você o usará nas chamadas de API.
pip install scrapy
scrapy startproject adspower_scraper
cd adspower_scraper
Crie um arquivo adspower_api.py na pasta do seu projeto:
import requests

API_BASE = "http://127.0.0.1:50325"

def start_browser(user_id):
    url = f"{API_BASE}/api/v1/browser/start"
    params = {"user_id": user_id}
    response = requests.get(url, params=params)
    data = response.json()
    if data["code"] != 0:
        raise Exception(f"Falha ao iniciar o navegador: {data['msg']}")
    return data["data"]["debug_port"]

def close_browser(user_id):
    url = f"{API_BASE}/api/v1/browser/stop"
    params = {"user_id": user_id}
    requests.get(url, params=params)
Aqui está um spider que raspa uma URL alvo usando um ambiente de navegador iniciado pelo AdsPower:
import scrapy
from scrapy.http import HtmlResponse
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from .adspower_api import start_browser, close_browser

class AdspowerSpider(scrapy.Spider):
    name = "adspower_spider"
    allowed_domains = ["example.com"]
    start_urls = ["http://example.com"]

    def __init__(self, user_id=None, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.user_id = user_id or "seu_user_id_aqui"

    def start_requests(self):
        # Iniciar o perfil do navegador AdsPower
        debug_port = start_browser(self.user_id)
        self.logger.info(f"Navegador iniciado na porta de depuração {debug_port}")

        # Conectar Selenium ao navegador existente
        chrome_options = Options()
        chrome_options.add_experimental_option("debuggerAddress", f"127.0.0.1:{debug_port}")
        driver = webdriver.Chrome(options=chrome_options)

        for url in self.start_urls:
            driver.get(url)
            body = driver.page_source
            response = HtmlResponse(url=url, body=body, encoding='utf-8')
            yield response

        driver.quit()
        close_browser(self.user_id)

    def parse(self, response):
        # Extrair dados usando seletores do Scrapy
        title = response.css('title::text').get()
        yield {"title": title}
scrapy crawl adspower_spider -a user_id=SEU_USER_ID
Vamos raspar preços de produtos de um site de e-commerce que usa impressão digital.
start_urls pela URL do produto.parse(), extraia preço, nome e disponibilidade.def parse(self, response):
product_name = response.css('h1.product-title::text').get()
price = response.css('span.price::text').get()
yield {
"name": product_name,
"price": price,
"url": response.url
}
Cada execução do spider usa uma impressão digital de navegador nova, fazendo a requisição parecer de um novo visitante.
Para sites com muito JavaScript, use Playwright em vez de Selenium:
from playwright.sync_api import sync_playwright

def fetch_page(url, debug_port):
    with sync_playwright() as p:
        browser = p.chromium.connect_over_cdp(f"http://127.0.0.1:{debug_port}")
        page = browser.new_page()
        page.goto(url)
        content = page.content()
        browser.close()
        return content
Depois, chame isso no start_requests do seu spider.
| Problema | Solução |
|---|---|
| API retorna código de erro | Certifique-se de que o cliente AdsPower está em execução e a porta da API está correta |
| Navegador não fecha | Chame close_browser() no método closed() do spider |
| Impressão digital ainda detectada | Atualize o AdsPower para a versão mais recente; verifique as configurações de falsificação de impressão digital |
| Proxy não funciona | Verifique o formato do proxy no perfil AdsPower (HTTP/SOCKS5) |
Sim. Inicie cada perfil com um user_id único e gerencie-os em paralelo usando a configuração CONCURRENT_REQUESTS do Scrapy.
O nível gratuito inclui 2 ambientes de navegador, o que é suficiente para testes. Para scraping em produção com muitos perfis, considere um plano pago.
Crie vários perfis AdsPower com impressões digitais diferentes. No seu spider, alterne entre valores de user_id para cada requisição.
A falsificação de impressão digital do AdsPower reduz significativamente o risco de detecção, mas nenhum método é 100% indetectável. Sempre respeite o robots.txt e os termos de serviço.
Integrar o navegador de impressão digital AdsPower com o Scrapy cria uma configuração de scraping robusta que contorna a detecção de impressão digital do navegador e associação de contas. Usando a API Local do AdsPower para lançar ambientes de navegador isolados, seus spiders do Scrapy podem raspar dados furtivamente em escala.
Para mais sobre navegadores anti-detecção, confira nossa comparação AdsPower vs Undetectable. Se você é novo na automação com AdsPower, nosso guia sobre como usar o AdsPower com Python cobre o básico.
Comece com uma conta gratuita do AdsPower e um spider Scrapy simples. Teste em um site de baixo risco e depois aumente a escala conforme ganhar confiança.


