
AdsPower vs ClonBrowser: який антидетект-браузер перемагає?
18 лист. 2026 р.
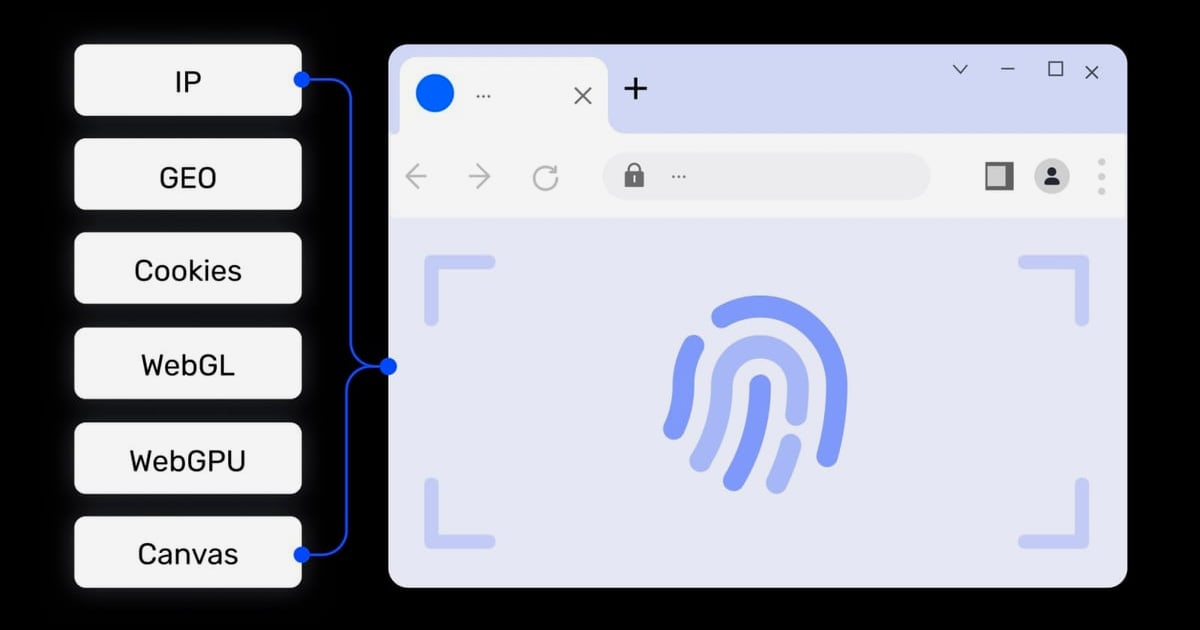
Веб-скрапінг у великих масштабах часто викликає спрацьовування антибот-заходів, які блокують або знімають відбитки вашого скрапера. Поєднання браузера з відбитками AdsPower з Scrapy дає вам потужний, непомітний конвеєр скрапінгу. AdsPower надає ізольовані середовища браузера з унікальними цифровими відбитками, тоді як Scrapy відповідає за обхід і вилучення даних. Разом вони вирішують проблеми прив'язки облікових записів, блокування IP та виявлення відбитків браузера.
Цей посібник проведе вас через робочий процес інтеграції, кроки налаштування, практичні приклади коду та конкретні проблеми, які вирішує це поєднання.
Інтерфейс продукту та огляд функцій How to Use AdsPower Fingerprint Browser with Scrapy.
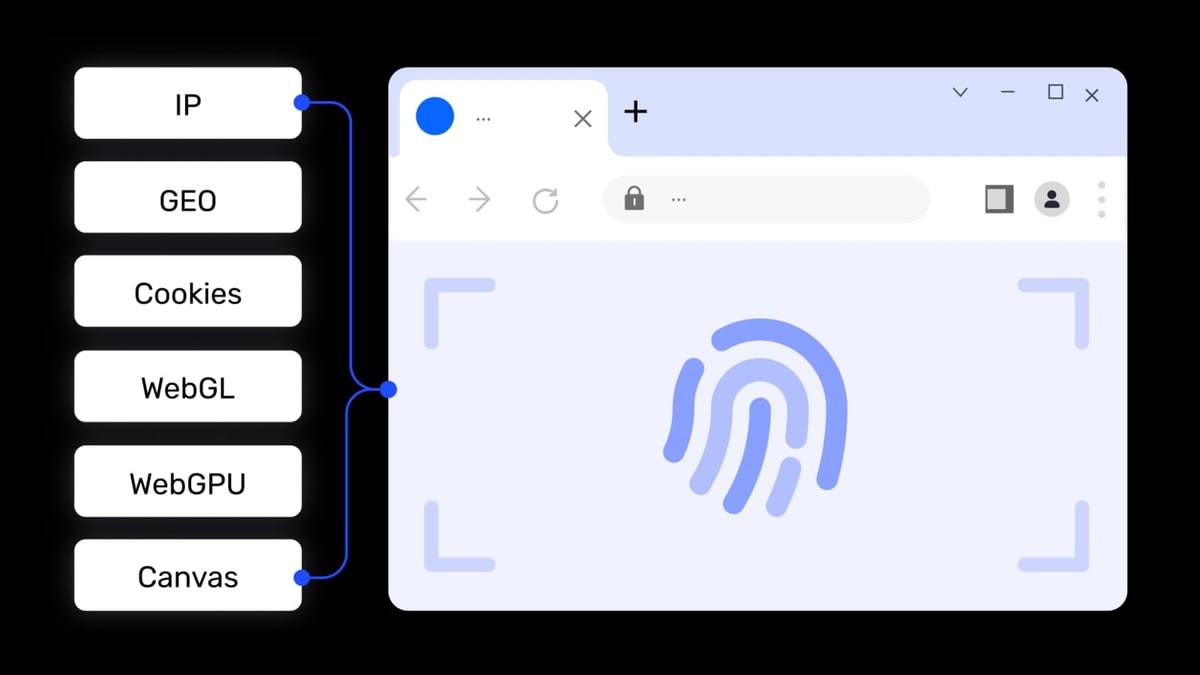
Scrapy — це швидкий асинхронний фреймворк Python для вилучення даних з веб-сайтів. Однак за замовчуванням він використовує необроблені HTTP-запити, що дозволяє сайтам легко виявляти та блокувати скрапери. AdsPower створює реальні середовища браузера з настроюваними відбитками (Canvas, WebGL, Audio, WebRTC тощо), роблячи кожен сеанс схожим на унікального користувача на іншому пристрої.
Проблеми, які вирішує це поєднання:
Інтерфейс продукту та огляд функцій How to Use AdsPower Fingerprint Browser with Scrapy.
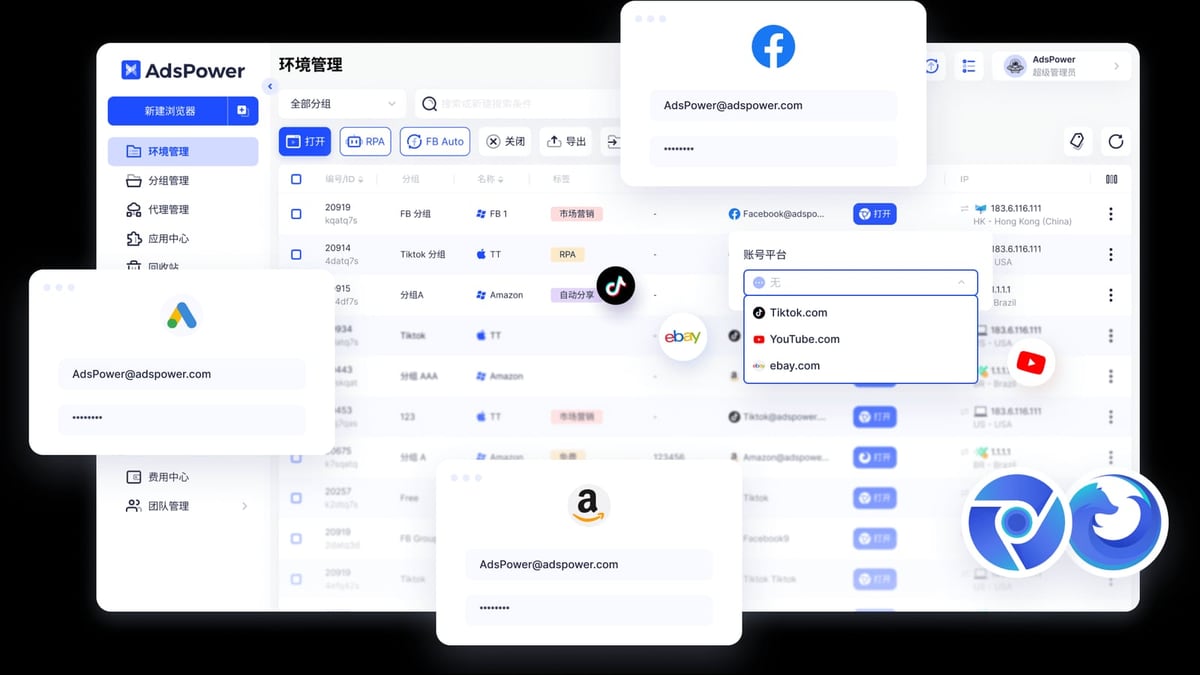
Робочий процес складається з трьох основних компонентів:
Ось загальний потік:
Інтерфейс продукту та огляд функцій How to Use AdsPower Fingerprint Browser with Scrapy.
Перш ніж почати, переконайтеся, що у вас є:
pip install scrapypip install requests
Інтерфейс продукту та огляд функцій How to Use AdsPower Fingerprint Browser with Scrapy.
Відкрийте AdsPower, перейдіть до Налаштування > API та зверніть увагу на порт API (за замовчуванням 50325). Тримайте клієнт AdsPower запущеним у фоновому режимі.
У AdsPower створіть новий профіль браузера. За потреби призначте проксі (HTTP, HTTPS, SOCKS5). Запам'ятайте user_id профілю – ви будете використовувати його в API-викликах.
pip install scrapy
scrapy startproject adspower_scraper
cd adspower_scraper
Створіть файл adspower_api.py у папці проекту:
import requests

API_BASE = "http://127.0.0.1:50325"

def start_browser(user_id):
    url = f"{API_BASE}/api/v1/browser/start"
    params = {"user_id": user_id}
    response = requests.get(url, params=params)
    data = response.json()
    if data["code"] != 0:
        raise Exception(f"Не вдалося запустити браузер: {data['msg']}")
    return data["data"]["debug_port"]

def close_browser(user_id):
    url = f"{API_BASE}/api/v1/browser/stop"
    params = {"user_id": user_id}
    requests.get(url, params=params)
Ось павук, який збирає дані з цільової URL-адреси за допомогою середовища браузера, запущеного AdsPower:
import scrapy
from scrapy.http import HtmlResponse
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from .adspower_api import start_browser, close_browser

class AdspowerSpider(scrapy.Spider):
    name = "adspower_spider"
    allowed_domains = ["example.com"]
    start_urls = ["http://example.com"]

    def __init__(self, user_id=None, *args, **kwargs):
        super().__init__(*args, **kwargs)
        self.user_id = user_id or "your_user_id_here"

    def start_requests(self):
        # Запускаємо профіль браузера AdsPower
        debug_port = start_browser(self.user_id)
        self.logger.info(f"Браузер запущено на порту налагодження {debug_port}")

        # Підключаємо Selenium до існуючого браузера
        chrome_options = Options()
        chrome_options.add_experimental_option("debuggerAddress", f"127.0.0.1:{debug_port}")
        driver = webdriver.Chrome(options=chrome_options)

        for url in self.start_urls:
            driver.get(url)
            body = driver.page_source
            response = HtmlResponse(url=url, body=body, encoding='utf-8')
            yield response

        driver.quit()
        close_browser(self.user_id)

    def parse(self, response):
        # Вилучаємо дані за допомогою селекторів Scrapy
        title = response.css('title::text').get()
        yield {"title": title}
scrapy crawl adspower_spider -a user_id=YOUR_USER_ID
Давайте зберемо ціни на товари з сайту електронної комерції, який використовує зняття відбитків.
start_urls на URL-адресу товару.parse() вилучіть ціну, назву та наявність.def parse(self, response):
product_name = response.css('h1.product-title::text').get()
price = response.css('span.price::text').get()
yield {
"name": product_name,
"price": price,
"url": response.url
}
Кожен запуск павука використовує новий відбиток браузера, що робить запит схожим на нового відвідувача.
Для сайтів з великою кількістю JavaScript використовуйте Playwright замість Selenium:
from playwright.sync_api import sync_playwright

def fetch_page(url, debug_port):
    with sync_playwright() as p:
        browser = p.chromium.connect_over_cdp(f"http://127.0.0.1:{debug_port}")
        page = browser.new_page()
        page.goto(url)
        content = page.content()
        browser.close()
        return content
Потім викличте це з start_requests вашого павука.
| Проблема | Рішення |
|---|---|
| API повертає код помилки | Переконайтеся, що клієнт AdsPower запущено та порт API правильний |
| Браузер не закривається | Викличте close_browser() у методі closed() павука |
| Відбиток все ще виявляється | Оновіть AdsPower до останньої версії; перевірте налаштування підробки відбитків |
| Проксі не працює | Перевірте формат проксі в профілі AdsPower (HTTP/SOCKS5) |
Так. Запустіть кожен профіль з унікальним user_id і керуйте ними паралельно за допомогою налаштування CONCURRENT_REQUESTS у Scrapy.
Безкоштовний тариф включає 2 середовища браузера, що достатньо для тестування. Для продуктивного скрапінгу з багатьма профілями розгляньте платний план.
Створіть кілька профілів AdsPower з різними відбитками. У вашому павуку циклічно перебирайте значення user_id для кожного запиту.
Підробка відбитків AdsPower значно знижує ризик виявлення, але жоден метод не є 100% непомітним. Завжди дотримуйтесь robots.txt та умов використання.
Інтеграція браузера з відбитками AdsPower з Scrapy створює надійну систему скрапінгу, яка обходить виявлення відбитків браузера та прив'язку облікових записів. Використовуючи AdsPower Local API для запуску ізольованих середовищ браузера, ваші павуки Scrapy можуть непомітно збирати дані у великих масштабах.
Щоб дізнатися більше про антидетект-браузери, перегляньте наше порівняння AdsPower та Undetectable. Якщо ви новачок в автоматизації AdsPower, наш посібник з використання AdsPower з Python охоплює основи.
Почніть з безкоштовного облікового запису AdsPower та простого павука Scrapy. Протестуйте на сайті з низьким ризиком, а потім масштабуйте, коли наберетеся впевненості.


