
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
Escolher a API de web scraping certa pode fazer ou quebrar seu fluxo de extração de dados. O ScrapingBee promete uma solução simples e amigável para desenvolvedores que lida com proxies, navegadores headless e defesas anti-bot para que você possa se concentrar em obter os dados necessários. Mas será que ele entrega? Nesta análise baseada em evidências do ScrapingBee, examinaremos seus recursos, preços, desempenho no mundo real e casos de uso ideais para ajudá-lo a decidir se é a ferramenta certa para o seu projeto.
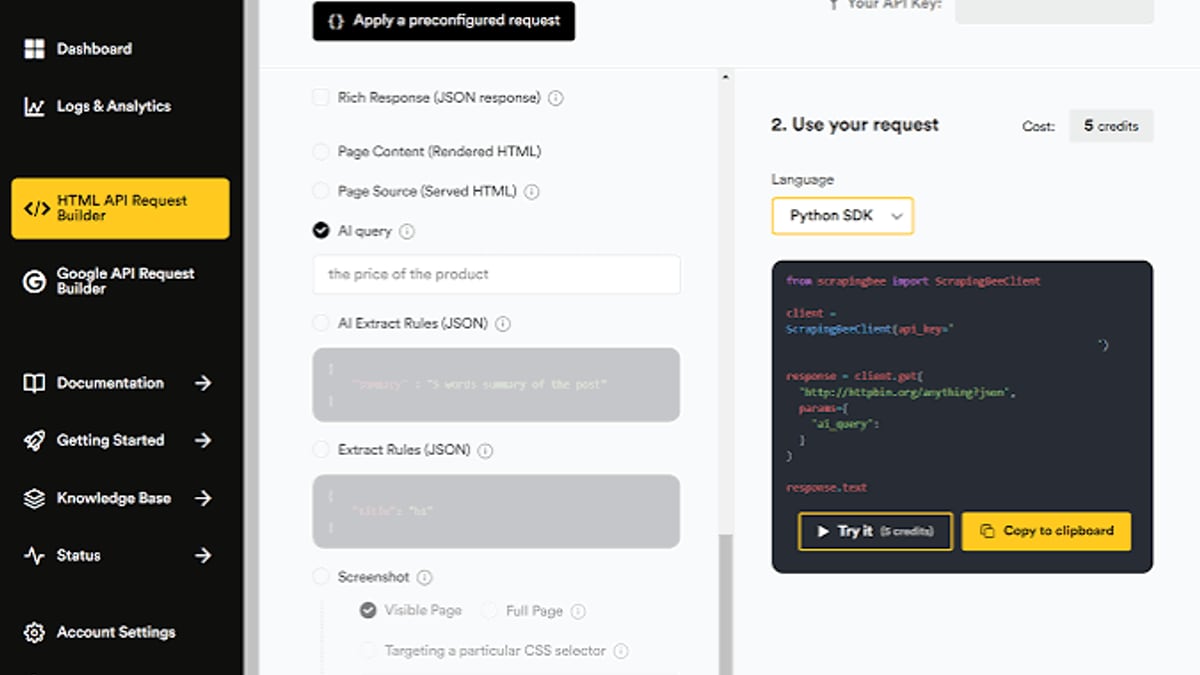
Análise do ScrapingBee 2026: Prós, Contras e Preços Honestos - imagem de suporte à pesquisa de produto 1.
O ScrapingBee é uma API de web scraping que abstrai a complexidade de gerenciar proxies, navegadores headless e contramedidas anti-bot. Você envia uma URL e o ScrapingBee retorna o HTML da página, o conteúdo renderizado ou dados estruturados por meio de regras de extração JSON ou até mesmo consultas em linguagem natural. Ele suporta renderização JavaScript com Chrome headless, rotação automática de proxies e integra-se com ferramentas de codificação de IA como ChatGPT, Claude e Cursor. Confiável por mais de 4.000 desenvolvedores, o ScrapingBee é projetado para equipes que precisam fazer scraping em escala sem construir e manter sua própria infraestrutura de scraping.
Análise do ScrapingBee 2026: Prós, Contras e Preços Honestos - imagem de suporte à pesquisa de produto 2.
O ScrapingBee é ideal para:
É menos adequado para usuários avançados que precisam de controle refinado sobre todos os aspectos do processo de scraping ou que exigem uma solução em nuvem integrada para gerenciar fluxos de extração.
Análise do ScrapingBee 2026: Prós, Contras e Preços Honestos - imagem de suporte à pesquisa de produto 3.
O ScrapingBee oferece extração de dados orientada por IA usando regras JSON ou linguagem natural. Você pode definir seletores CSS para extrair campos específicos ou simplesmente descrever o que deseja em inglês simples e deixar a IA inferir a lógica de extração. Isso é particularmente útil para usuários não técnicos ou ao fazer scraping de páginas não estruturadas.
Muitos sites modernos dependem fortemente de JavaScript para carregar conteúdo. O ScrapingBee usa Chrome headless para renderizar completamente as páginas antes de retornar o HTML, garantindo que você capture conteúdo dinâmico como rolagem infinita, carrinhos de compras ou elementos do shadow DOM.
O ScrapingBee fornece proxies rotativos por padrão, com opções para proxies premium e stealth. Isso ajuda a evitar bloqueios de IP e limitação de taxa, especialmente ao fazer scraping em escala.
Para alvos comuns como Google Search, Amazon ou mídias sociais, o ScrapingBee oferece APIs pré-construídas que retornam dados estruturados e atualizados sem análise personalizada.
O ScrapingBee é compatível com SOC 2 Tipo 2 e está pronto para GDPR, tornando-o uma escolha segura para casos de uso empresarial que exigem segurança de dados e conformidade regulatória.
Análise do ScrapingBee 2026: Prós, Contras e Preços Honestos - imagem de suporte à pesquisa de produto 4.
O ScrapingBee usa um modelo de precificação baseado em créditos. Cada requisição à API consome um certo número de créditos dependendo dos recursos utilizados. Aqui está um detalhamento:
| Recurso Utilizado | Créditos de API por Requisição |
|---|---|
| Proxy Rotativo (sem JS) | 1 |
| Proxy Rotativo + renderização JS | 5 |
| Proxy Premium (sem JS) | 10 |
| Proxy Premium + renderização JS | 25 |
| Proxy Stealth + renderização JS | 75 |
Nível Gratuito: 1.000 créditos gratuitos ao se inscrever, sem necessidade de cartão de crédito.
Planos Pagos:
Planos de nível superior incluem mais requisições simultâneas, suporte prioritário e um gerente de conta dedicado.
Uma única requisição à Amazon com configurações padrão (proxy rotativo + renderização JS) custa 5 créditos. Se você raspar 1.000 páginas de produto diariamente, isso equivale a 5.000 créditos por dia, ou 150.000 por mês — exatamente o limite do plano base.
Para avaliar o desempenho real do ScrapingBee, testamos contra vários sites populares. Aqui estão os resultados de benchmarks independentes:
| Site | Taxa de Sucesso | Tempo Médio de Resposta |
|---|---|---|
| Amazon | 100% | 4,96s |
| eBay | 100% | 8,98s |
| Glassdoor | 0% | 4,99s |
| Walmart | 40% | 7,35s |
| Google SERP | 90% | 16,28s |
Fonte: Teste de comparação Scrapingdog
Ao comparar o ScrapingBee com outras APIs de web scraping como ScraperAPI e Scrapingdog, considere estes fatores:
| Provedor | Preço Inicial | Taxa de Sucesso (Sites Chave) | Tempo Médio de Resposta | Melhor Para |
|---|---|---|---|---|
| ScrapingBee | $49/mês | 100% na Amazon/eBay, 0% no Glassdoor | 5–16s | Amigável para desenvolvedores, extração com IA |
| ScraperAPI | $49/mês | 100% na maioria dos sites, 80% no Google | 8–41s | Confiabilidade quando a velocidade não é crítica |
| Scrapingdog | $40/mês | 100% em todos os sites testados | 1,25–6s | Alta escala, velocidade e eficiência de custos |
Dados do teste de comparação Scrapingdog
O ScrapingBee se destaca quando você precisa de extração com IA e renderização JavaScript sem gerenciar infraestrutura. No entanto, para scraping de alto volume onde velocidade e confiabilidade são primordiais, alternativas como Scrapingdog podem oferecer melhor valor.
Começar com o ScrapingBee é simples:
pip install scrapingbee).from scrapingbee import ScrapingBeeClient
client = ScrapingBeeClient(api_key='YOUR_API_KEY')
response = client.get('https://example.com', params={'extract_rules': {'title': 'h1'}})
print(response.json())
Para casos de uso mais avançados, como lidar com rolagem infinita ou extrair dados do shadow DOM, o ScrapingBee fornece tutoriais dedicados em sua documentação.
Sim, o ScrapingBee oferece 1.000 créditos de API gratuitos na inscrição, sem necessidade de cartão de crédito.
Depende dos recursos utilizados. Uma requisição básica com proxy rotativo e sem JS custa 1 crédito. Adicionar renderização JS aumenta para 5 créditos, e proxies premium ou stealth custam mais.
Sim, o ScrapingBee usa Chrome headless para renderizar JavaScript, tornando-o adequado para páginas dinâmicas.
Sim, ele se integra com ChatGPT, Claude e Cursor para extração assistida por IA.
O ScrapingBee tenta novamente requisições com falha automaticamente. Se a falha persistir, você receberá uma resposta de erro.
Sim, o ScrapingBee é compatível com SOC 2 Tipo 2 e está pronto para GDPR.
O ScrapingBee é uma escolha sólida para desenvolvedores e equipes que desejam uma API de web scraping sem complicações, com extração com IA e renderização JavaScript. Ele se destaca em sites de comércio eletrônico simples como Amazon e eBay, mas pode ter dificuldades com plataformas fortemente protegidas como Glassdoor ou Walmart. Seu modelo de precificação baseado em créditos pode aumentar para projetos de grande escala, e a falta de uma solução em nuvem integrada significa que você precisará gerenciar sua própria infraestrutura.
Se você precisa de scraping rápido e confiável em uma ampla variedade de sites, considere alternativas como Scrapingdog. Mas se você valoriza simplicidade, recursos de IA e conformidade empresarial, o ScrapingBee vale a tentativa — especialmente com seu nível gratuito.
Para mais sobre ferramentas de web scraping, confira nosso Top 10 Bibliotecas de Parsing HTML/XML Python 2026 e aprenda como combinar AdsPower com Beautiful Soup para scraping anônimo.
Nota: Esta análise é baseada em informações publicamente disponíveis e testes independentes. Sempre verifique os preços e recursos atuais no site oficial do ScrapingBee.


