
AdsPower vs ClonBrowser: Qual Navegador Anti-Detecção Vence?
18 de nov. de 2026
Analisar HTML e XML é uma habilidade essencial para qualquer desenvolvedor Python que trabalhe com dados da web. Seja extraindo preços de produtos, coletando artigos de notícias ou processando feeds XML, a biblioteca de análise certa pode economizar horas de trabalho. Em 2026, o ecossistema Python oferece um conjunto rico de ferramentas, cada uma com seus pontos fortes. Este guia classifica as 10 principais bibliotecas Python para análise de HTML/XML com base em velocidade, facilidade de uso, precisão, suporte da comunidade e adequação para diferentes tipos de projeto.
Avaliamos cada biblioteca usando critérios transparentes: velocidade de análise, tratamento de marcação malformada, suporte a seletores CSS e XPath, qualidade da documentação, manutenção ativa e integração com o ecossistema. Também consideramos casos de uso reais, desde raspadores rápidos e únicos até pipelines de dados em larga escala.
Interface do produto e visão geral dos recursos das Top 10 Bibliotecas Python para Análise de HTML/XML em 2026.
Beautiful Soup 4 continua sendo a biblioteca de análise de HTML/XML Python mais amigável para iniciantes e amplamente utilizada. Ela se destaca em transformar HTML confuso e do mundo real em uma árvore de análise navegável com código mínimo. Você pode encontrar elementos por nome de tag, classe CSS, ID, atributo ou até mesmo com expressões regulares.
Principais pontos fortes:
Limitações:
Exemplo:
from bs4 import BeautifulSoup

html = "<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>"
soup = BeautifulSoup(html, 'html.parser')
print(soup.select_one('.price').text)  # Saída: $19.99
Beautiful Soup é ideal para prototipagem rápida, tarefas de raspagem de pequeno a médio porte e projetos onde a legibilidade do código é mais importante que a velocidade bruta. É mantido por Leonard Richardson e disponível sob licença de código aberto. Para suporte empresarial, a Tidelift oferece assinaturas.
Interface do produto e visão geral dos recursos das Top 10 Bibliotecas Python para Análise de HTML/XML em 2026.
lxml é o rei do desempenho na análise de XML e HTML em Python. Construído sobre as bibliotecas C libxml2 e libxslt, ele oferece análise extremamente rápida e suporte completo a XPath. Também suporta seletores CSS através do módulo cssselect.
Principais pontos fortes:
Limitações:
Exemplo:
from lxml import html

tree = html.fromstring("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(tree.xpath("//span[@class='price']/text()")[0])  # Saída: $19.99
lxml é a escolha ideal para raspagem de alto desempenho, grandes conjuntos de dados XML e qualquer projeto onde XPath seja essencial. Também é o backend recomendado para Beautiful Soup quando a velocidade importa.
Interface do produto e visão geral dos recursos das Top 10 Bibliotecas Python para Análise de HTML/XML em 2026.
html5lib é um analisador HTML puro em Python que segue a especificação completa do HTML5. Ele analisa HTML exatamente como um navegador moderno faria, tornando-se o analisador mais preciso para lidar com marcação quebrada ou não padrão.
Principais pontos fortes:
Limitações:
Exemplo (via Beautiful Soup):
from bs4 import BeautifulSoup

messy_html = "<div><p>Hello<br>World</div>"
soup = BeautifulSoup(messy_html, 'html5lib')
print(soup.p.text)  # Saída: Hello World
Use html5lib quando a precisão for primordial e a velocidade não for uma preocupação—por exemplo, quando você precisa analisar HTML exatamente como um navegador faria para testes de conformidade ou ao lidar com páginas extremamente malformadas.
Interface do produto e visão geral dos recursos das Top 10 Bibliotecas Python para Análise de HTML/XML em 2026.
O módulo html.parser embutido do Python está sempre disponível—sem necessidade de instalação. Ele fornece um analisador simples orientado a eventos que pode lidar com tarefas básicas de análise de HTML.
Principais pontos fortes:
Limitações:
Exemplo:
from html.parser import HTMLParser

class MyParser(HTMLParser):
    def handle_data(self, data):
        print("Data:", data)

parser = MyParser()
parser.feed("<p>Hello World</p>")
html.parser é melhor para scripts rápidos e únicos onde você controla a qualidade do HTML, ou para ambientes onde instalar pacotes de terceiros não é uma opção.
PyQuery traz a sintaxe estilo jQuery para Python. Se você vem de um background de front-end, se sentirá em casa. Ele usa lxml internamente para velocidade.
Principais pontos fortes:
Limitações:
Exemplo:
from pyquery import PyQuery as pq

doc = pq("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(doc(".price").text())  # Saída: $19.99
PyQuery é uma ótima escolha para desenvolvedores que preferem código compacto e encadeável e já estão confortáveis com seletores jQuery.
selectolax é uma biblioteca relativamente nova, mas poderosa, que envolve os motores Modest e Lexbor para análise rápida de HTML com suporte a seletores CSS. É projetada para velocidade e baixo uso de memória.
Principais pontos fortes:
Limitações:
Exemplo:
from selectolax.parser import HTMLParser

parser = HTMLParser("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(parser.css_first('.price').text())  # Saída: $19.99
selectolax é ideal para pipelines de raspagem de alto rendimento onde memória e velocidade são críticas, e você só precisa de seletores CSS.
Parsel é a biblioteca por trás do mecanismo de seletores do Scrapy. Ela fornece uma API limpa e unificada para extrair dados usando seletores CSS e expressões XPath, construída sobre o lxml.
Principais pontos fortes:
Limitações:
Exemplo:
from parsel import Selector

sel = Selector(text="<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(sel.css('.price::text').get())  # Saída: $19.99
print(sel.xpath('//span[@class="price"]/text()').get())  # Saída: $19.99
Parsel é uma excelente escolha se você deseja uma API de seletor unificada e pode migrar posteriormente para o Scrapy para raspagem em grande escala.
A biblioteca padrão do Python inclui xml.etree.ElementTree para analisar e criar documentos XML. É leve e suficiente para muitas tarefas de processamento XML.
Principais pontos fortes:
Limitações:
Exemplo:
import xml.etree.ElementTree as ET

xml_data = """<catalog><book id="1"><title>Python 101</title></book></catalog>"""
root = ET.fromstring(xml_data)
print(root.find('.//title').text)  # Saída: Python 101
Use ElementTree para documentos XML bem formados, arquivos de configuração ou quando não puder adicionar dependências externas.
A segurança é uma preocupação crítica ao analisar XML de fontes não confiáveis. defusedxml é um substituto imediato para os analisadores XML padrão que protege contra ataques XML comuns como billion laughs e quadratic blowup.
Principais pontos fortes:
Limitações:
Exemplo:
from defusedxml import ElementTree as DET

safe_tree = DET.parse('untrusted.xml')
Sempre use defusedxml ao analisar XML de fontes externas ou fornecidas pelo usuário. É indispensável para aplicações preocupadas com segurança.
xml.dom.minidom é uma implementação mínima da interface Document Object Model (DOM) para XML. Fornece uma estrutura de árvore DOM familiar, mas é mais pesado que ElementTree.
Principais pontos fortes:
Limitações:
Exemplo:
from xml.dom.minidom import parseString

dom = parseString("<root><item>Data</item></root>")
print(dom.getElementsByTagName('item')[0].firstChild.nodeValue)  # Saída: Data
minidom é útil para manipulação rápida de DOM de documentos XML pequenos ou quando você precisa de uma interface DOM padrão.
| Biblioteca | Velocidade | Facilidade de Uso | Precisão | Seletores CSS | XPath | Melhor Para |
|---|---|---|---|---|---|---|
| Beautiful Soup 4 | Média | Alta | Média | Sim | Via lxml | Iniciantes, raspadores rápidos |
| lxml | Muito Alta | Média | Alta | Sim | Sim | Desempenho, XPath |
| html5lib | Baixa | Média | Muito Alta | Via BS4 | Não | Tarefas críticas de precisão |
| html.parser | Alta | Baixa | Baixa | Não | Não | Scripts simples, sem dependências |
| PyQuery | Média | Alta | Média | Sim | Não | Amantes de jQuery |
| selectolax | Muito Alta | Média | Alta | Sim | Não | Pipelines de alto rendimento |
| parsel | Alta | Alta | Alta | Sim | Sim | API de seletor unificada |
| ElementTree | Alta | Média | Alta (XML) | Não | Limitado | Processamento XML |
| defusedxml | Média | Alta | Alta (XML) | Não | Limitado | Análise segura de XML |
| minidom | Baixa | Média | Alta (XML) | Não | Não | Tarefas DOM XML pequenas |
Sua escolha depende de suas necessidades específicas:
Qual biblioteca é melhor para web scraping em 2026?
Para a maioria dos projetos de web scraping, Beautiful Soup 4 com lxml como backend oferece o melhor equilíbrio entre facilidade de uso e desempenho. Para raspagem em larga escala, considere lxml diretamente ou selectolax.
Posso usar essas bibliotecas com um navegador anti-detecção?
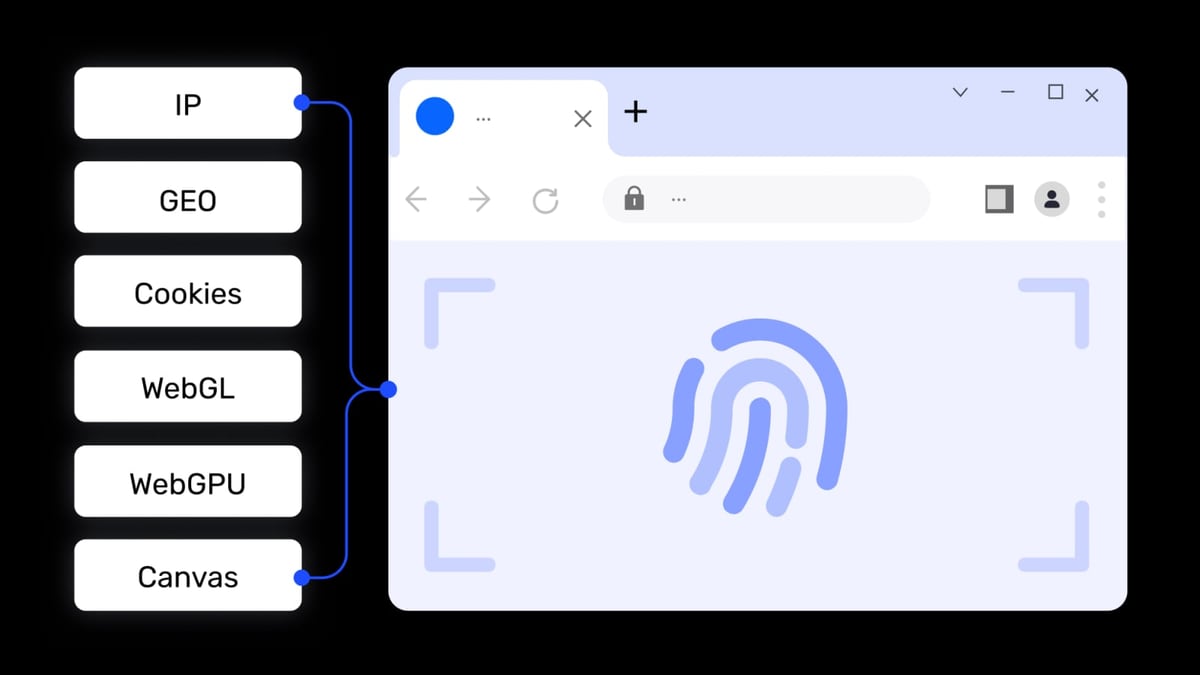
Sim. Ao raspar sites com fortes medidas anti-bot, você pode combinar uma biblioteca de análise com um navegador anti-detecção como AdsPower para gerenciar impressões digitais do navegador e evitar detecção. Por exemplo, você pode usar a API local do AdsPower para controlar perfis de navegador e alimentar o código-fonte da página para Beautiful Soup para análise. Veja nosso guia sobre como usar AdsPower com Beautiful Soup para uma configuração passo a passo.
Preciso aprender XPath?
XPath é poderoso, mas não obrigatório. Seletores CSS cobrem a maioria dos casos de uso comuns. Se você trabalha com XML ou precisa de consultas complexas, aprender XPath vale a pena.
Existem novas bibliotecas em 2026?
Selectolax ganhou popularidade por sua velocidade e baixo uso de memória. Fique de olho nos motores Modest e Lexbor que ele envolve.
O ecossistema de análise de HTML e XML do Python em 2026 é maduro e diversificado. Seja você um iniciante escrevendo seu primeiro raspador ou um engenheiro de dados construindo um pipeline de alto rendimento, há uma biblioteca que atende às suas necessidades. Beautiful Soup 4 continua sendo a melhor escolha para a maioria dos desenvolvedores, enquanto lxml e selectolax oferecem desempenho superior para tarefas exigentes. Para XML, as opções da biblioteca padrão combinadas com defusedxml fornecem uma base sólida.
Lembre-se de sempre respeitar os termos de serviço do site e o robots.txt ao raspar. Use ferramentas apropriadas como proxies e navegadores anti-detecção quando necessário e lide com os dados de forma responsável.
Para mais comparações de ferramentas que complementam seu fluxo de trabalho de raspagem, confira nossa comparação de navegadores anti-detecção ou aprenda sobre plataformas de dados de mercado de criptomoedas que muitas vezes dependem de bibliotecas de análise internamente.


