
AdsPower vs ClonBrowser: який антидетект-браузер перемагає?
18 лист. 2026 р.
Парсинг HTML та XML є ключовим навиком для будь-якого розробника Python, який працює з веб-даними. Незалежно від того, чи ви отримуєте ціни на товари, збираєте новинні статті або обробляєте XML-фіди, правильна бібліотека для парсингу може заощадити вам години роботи. У 2026 році екосистема Python пропонує багатий набір інструментів, кожен зі своїми сильними сторонами. Цей посібник ранжує топ-10 бібліотек Python для парсингу HTML/XML на основі швидкості, простоти використання, точності, підтримки спільноти та придатності для різних типів проектів.
Ми оцінили кожну бібліотеку за прозорими критеріями: швидкість парсингу, обробка некоректної розмітки, підтримка CSS-селекторів та XPath, якість документації, активна підтримка та інтеграція з екосистемою. Ми також врахували реальні сценарії використання: від швидких одноразових скраперів до масштабних конвеєрів даних.
Інтерфейс продукту та огляд функцій топ-10 бібліотек Python для парсингу HTML/XML у 2026 році.
Beautiful Soup 4 залишається найбільш зручною для початківців та широко використовуваною бібліотекою Python для парсингу HTML/XML. Вона чудово перетворює неохайний, реальний HTML у навігаційне дерево розбору з мінімальним кодом. Ви можете знаходити елементи за назвою тегу, CSS-класом, ID, атрибутом або навіть за допомогою регулярних виразів.
Ключові переваги:
Обмеження:
Приклад:
from bs4 import BeautifulSoup

html = "<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>"
soup = BeautifulSoup(html, 'html.parser')
print(soup.select_one('.price').text)  # Вивід: $19.99
Beautiful Soup ідеально підходить для швидкого прототипування, невеликих та середніх завдань зі скрапінгу та проектів, де читабельність коду важливіша за сиру швидкість. Її підтримує Leonard Richardson, і вона доступна за відкритою ліцензією. Для корпоративної підтримки Tidelift пропонує підписки.
Інтерфейс продукту та огляд функцій топ-10 бібліотек Python для парсингу HTML/XML у 2026 році.
lxml — король продуктивності серед бібліотек Python для парсингу XML та HTML. Побудований на основі C-бібліотек libxml2 та libxslt, він забезпечує блискавичний парсинг та повну підтримку XPath. Також підтримує CSS-селектори через модуль cssselect.
Ключові переваги:
Обмеження:
Приклад:
from lxml import html

tree = html.fromstring("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(tree.xpath("//span[@class='price']/text()")[0])  # Вивід: $19.99
lxml — вибір для високопродуктивного скрапінгу, великих XML-наборів даних та будь-яких проектів, де XPath є важливим. Він також є рекомендованим бекендом для Beautiful Soup, коли швидкість має значення.
Інтерфейс продукту та огляд функцій топ-10 бібліотек Python для парсингу HTML/XML у 2026 році.
html5lib — це чистий Python-парсер HTML, який слідує повній специфікації HTML5. Він парсить HTML точно так, як це робить сучасний браузер, що робить його найточнішим парсером для обробки зламаної або нестандартної розмітки.
Ключові переваги:
Обмеження:
Приклад (через Beautiful Soup):
from bs4 import BeautifulSoup

messy_html = "<div><p>Hello<br>World</div>"
soup = BeautifulSoup(messy_html, 'html5lib')
print(soup.p.text)  # Вивід: Hello World
Використовуйте html5lib, коли точність є найважливішою, а швидкість не має значення — наприклад, коли потрібно парсити HTML точно так, як це робить браузер, для тестування відповідності або при роботі з надзвичайно зламаними сторінками.
Інтерфейс продукту та огляд функцій топ-10 бібліотек Python для парсингу HTML/XML у 2026 році.
Вбудований модуль Python html.parser завжди доступний — не потрібно встановлювати. Він надає простий подієво-орієнтований парсер, який може виконувати базові завдання парсингу HTML.
Ключові переваги:
Обмеження:
Приклад:
from html.parser import HTMLParser

class MyParser(HTMLParser):
    def handle_data(self, data):
        print("Data:", data)

parser = MyParser()
parser.feed("<p>Hello World</p>")
html.parser найкраще підходить для швидких одноразових скриптів, де ви контролюєте якість HTML, або для середовищ, де встановлення сторонніх пакетів неможливе.
PyQuery приносить синтаксис jQuery у Python. Якщо ви маєте досвід фронтенд-розробки, ви відчуєте себе як вдома. Він використовує lxml під капотом для швидкості.
Ключові переваги:
Обмеження:
Приклад:
from pyquery import PyQuery as pq

doc = pq("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(doc(".price").text())  # Вивід: $19.99
PyQuery — чудовий вибір для розробників, які віддають перевагу компактному, ланцюжковому коду та вже знайомі з селекторами jQuery.
selectolax — відносно нова, але потужна бібліотека, яка обгортає рушії Modest та Lexbor для швидкого парсингу HTML з підтримкою CSS-селекторів. Вона розроблена для швидкості та низького використання пам'яті.
Ключові переваги:
Обмеження:
Приклад:
from selectolax.parser import HTMLParser

parser = HTMLParser("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(parser.css_first('.price').text())  # Вивід: $19.99
selectolax ідеально підходить для високопродуктивних конвеєрів скрапінгу, де пам'ять та швидкість є критичними, і вам потрібні лише CSS-селектори.
Parsel — це бібліотека, що лежить в основі рушія селекторів Scrapy. Вона надає чистий, уніфікований API для вилучення даних за допомогою CSS-селекторів та виразів XPath, побудований на основі lxml.
Ключові переваги:
Обмеження:
Приклад:
from parsel import Selector

sel = Selector(text="<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(sel.css('.price::text').get())  # Вивід: $19.99
print(sel.xpath('//span[@class="price"]/text()').get())  # Вивід: $19.99
Parsel — відмінний вибір, якщо ви хочете мати уніфікований API селекторів і, можливо, пізніше перейти на Scrapy для повномасштабного краулінгу.
Стандартна бібліотека Python включає xml.etree.ElementTree для парсингу та створення XML-документів. Він легкий і достатній для багатьох завдань обробки XML.
Ключові переваги:
Обмеження:
Приклад:
import xml.etree.ElementTree as ET

xml_data = """<catalog><book id="1"><title>Python 101</title></book></catalog>"""
root = ET.fromstring(xml_data)
print(root.find('.//title').text)  # Вивід: Python 101
Використовуйте ElementTree для добре сформованих XML-документів, файлів конфігурації або коли не можна додавати зовнішні залежності.
Безпека є критично важливою при парсингу XML з ненадійних джерел. defusedxml — це заміна стандартних XML-парсерів, яка захищає від поширених XML-атак, таких як billion laughs та quadratic blowup.
Ключові переваги:
Обмеження:
Приклад:
from defusedxml import ElementTree as DET

safe_tree = DET.parse('untrusted.xml')
Завжди використовуйте defusedxml при парсингу XML із зовнішніх або наданих користувачем джерел. Це обов'язково для додатків, де безпека має значення.
xml.dom.minidom — це мінімальна реалізація інтерфейсу Document Object Model (DOM) для XML. Він надає знайому структуру дерева DOM, але є важчим за ElementTree.
Ключові переваги:
Обмеження:
Приклад:
from xml.dom.minidom import parseString

dom = parseString("<root><item>Data</item></root>")
print(dom.getElementsByTagName('item')[0].firstChild.nodeValue)  # Вивід: Data
minidom корисний для швидкої DOM-маніпуляції невеликими XML-документами або коли потрібен стандартний DOM-інтерфейс.
| Бібліотека | Швидкість | Простота використання | Точність | CSS-селектори | XPath | Найкраще підходить для |
|---|---|---|---|---|---|---|
| Beautiful Soup 4 | Середня | Висока | Середня | Так | Через lxml | Початківці, швидкі скрапери |
| lxml | Дуже висока | Середня | Висока | Так | Так | Продуктивність, XPath |
| html5lib | Низька | Середня | Дуже висока | Через BS4 | Ні | Завдання, де важлива точність |
| html.parser | Висока | Низька | Низька | Ні | Ні | Прості скрипти без залежностей |
| PyQuery | Середня | Висока | Середня | Так | Ні | Шанувальники jQuery |
| selectolax | Дуже висока | Середня | Висока | Так | Ні | Високопродуктивні конвеєри |
| parsel | Висока | Висока | Висока | Так | Так | Уніфікований API селекторів |
| ElementTree | Висока | Середня | Висока (XML) | Ні | Обмежена | Обробка XML |
| defusedxml | Середня | Висока | Висока (XML) | Ні | Обмежена | Безпечний парсинг XML |
| minidom | Низька | Середня | Висока (XML) | Ні | Ні | Невеликі завдання DOM для XML |
Ваш вибір залежить від ваших конкретних потреб:
Яка бібліотека найкраща для веб-скрапінгу у 2026 році?
Для більшості проектів веб-скрапінгу Beautiful Soup 4 з lxml як бекендом пропонує найкращий баланс простоти використання та продуктивності. Для масштабного скрапінгу розгляньте безпосередньо lxml або selectolax.
Чи можна використовувати ці бібліотеки з антидетект-браузером?
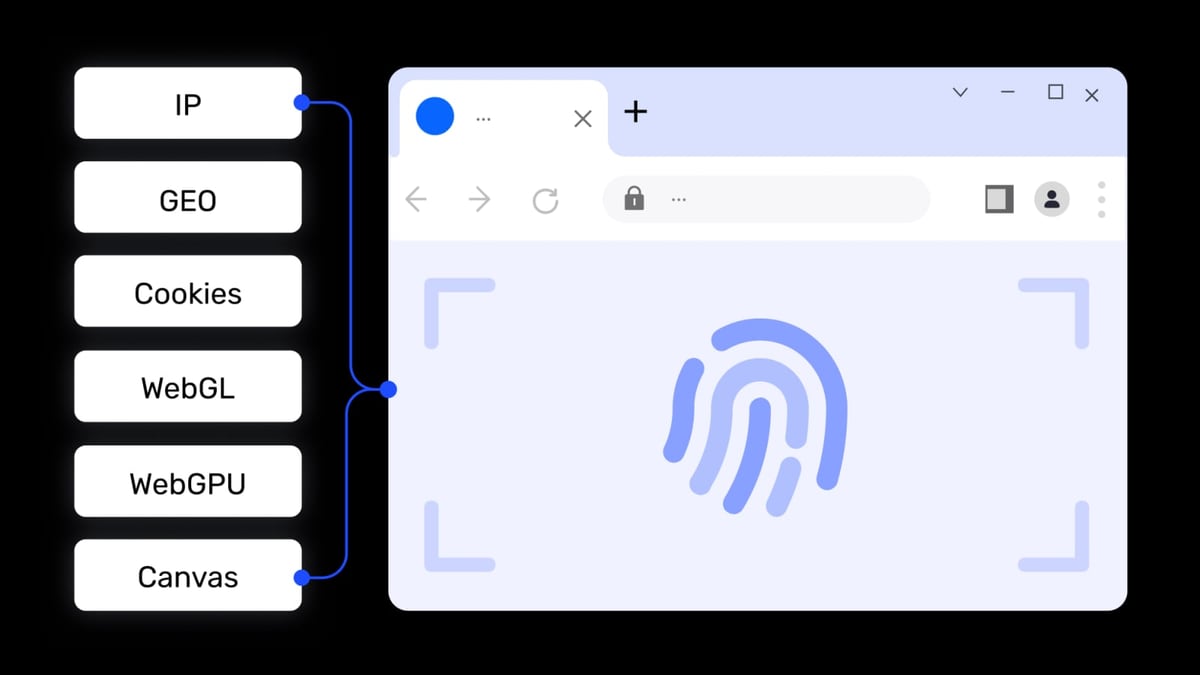
Так. При скрапінгу сайтів із сильними заходами проти ботів ви можете поєднати бібліотеку парсингу з антидетект-браузером, таким як AdsPower, для керування відбитками браузера та уникнення виявлення. Наприклад, ви можете використовувати локальний API AdsPower для керування профілями браузера та передавати вихідний код сторінки Beautiful Soup для парсингу. Перегляньте наш посібник з використання AdsPower з Beautiful Soup для покрокового налаштування.
Чи потрібно вивчати XPath?
XPath потужний, але не обов'язковий. CSS-селектори покривають більшість поширених випадків. Якщо ви працюєте з XML або потребуєте складних запитів, вивчення XPath варте зусиль.
Чи є нові бібліотеки у 2026 році?
Selectolax набув популярності завдяки своїй швидкості та низькому використанню пам'яті. Слідкуйте за рушіями Modest та Lexbor, які він обгортає.
Екосистема парсингу HTML та XML у Python у 2026 році є зрілою та різноманітною. Незалежно від того, чи ви початківець, який пише свій перший скрапер, чи інженер даних, який будує високопродуктивний конвеєр, знайдеться бібліотека, яка відповідає вашим потребам. Beautiful Soup 4 залишається найкращим вибором для більшості розробників, тоді як lxml та selectolax пропонують вищу продуктивність для вимогливих завдань. Для XML варіанти зі стандартної бібліотеки в поєднанні з defusedxml забезпечують надійну основу.
Пам'ятайте завжди поважати умови використання веб-сайтів та robots.txt під час скрапінгу. Використовуйте відповідні інструменти, такі як проксі та антидетект-браузери, коли це необхідно, та відповідально ставтеся до даних.
Для додаткових порівнянь інструментів, які доповнюють ваш робочий процес скрапінгу, перегляньте наше порівняння антидетект-браузерів або дізнайтеся про платформи даних криптовалютного ринку, які часто покладаються на бібліотеки парсингу під капотом.


