
AdsPower vs ClonBrowser: Trình duyệt chống phát hiện nào chiến thắng?
18 thg 11, 2026
Phân tích cú pháp HTML và XML là kỹ năng cốt lõi cho bất kỳ nhà phát triển Python nào làm việc với dữ liệu web. Dù bạn đang trích xuất giá sản phẩm, thu thập tin tức hay xử lý nguồn cấp dữ liệu XML, thư viện phân tích cú pháp phù hợp có thể giúp bạn tiết kiệm hàng giờ làm việc. Năm 2026, hệ sinh thái Python cung cấp nhiều công cụ phong phú, mỗi công cụ có điểm mạnh riêng. Hướng dẫn này xếp hạng 10 thư viện phân tích cú pháp HTML/XML Python hàng đầu dựa trên tốc độ, dễ sử dụng, độ chính xác, hỗ trợ cộng đồng và phù hợp với các loại dự án khác nhau.
Chúng tôi đánh giá từng thư viện bằng các tiêu chí minh bạch: tốc độ phân tích cú pháp, xử lý markup lỗi, hỗ trợ bộ chọn CSS và XPath, chất lượng tài liệu, bảo trì tích cực và tích hợp hệ sinh thái. Chúng tôi cũng xem xét các trường hợp sử dụng thực tế, từ các trình thu thập dữ liệu nhanh một lần đến các pipeline dữ liệu quy mô lớn.
Giao diện sản phẩm và tổng quan tính năng Top 10 Thư viện Phân tích cú pháp HTML/XML Python 2026.
Beautiful Soup 4 vẫn là thư viện phân tích cú pháp HTML/XML Python thân thiện với người mới bắt đầu và được sử dụng rộng rãi nhất. Nó xuất sắc trong việc biến HTML thực tế lộn xộn thành cây phân tích có thể điều hướng với mã tối thiểu. Bạn có thể tìm phần tử theo tên thẻ, lớp CSS, ID, thuộc tính hoặc thậm chí bằng biểu thức chính quy.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from bs4 import BeautifulSoup

html = "<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>"
soup = BeautifulSoup(html, 'html.parser')
print(soup.select_one('.price').text)  # Đầu ra: $19.99
Beautiful Soup lý tưởng cho tạo mẫu nhanh, các tác vụ thu thập dữ liệu nhỏ đến vừa và các dự án mà khả năng đọc mã quan trọng hơn tốc độ thô. Nó được duy trì bởi Leonard Richardson và có sẵn theo giấy phép mã nguồn mở. Để hỗ trợ doanh nghiệp, Tidelift cung cấp đăng ký.
Giao diện sản phẩm và tổng quan tính năng Top 10 Thư viện Phân tích cú pháp HTML/XML Python 2026.
lxml là vua hiệu suất của phân tích cú pháp XML và HTML Python. Được xây dựng trên các thư viện C libxml2 và libxslt, nó cung cấp phân tích cú pháp cực nhanh và hỗ trợ XPath đầy đủ. Nó cũng hỗ trợ bộ chọn CSS thông qua mô-đun cssselect.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from lxml import html

tree = html.fromstring("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(tree.xpath("//span[@class='price']/text()")[0])  # Đầu ra: $19.99
lxml là lựa chọn hàng đầu cho thu thập dữ liệu hiệu suất cao, tập dữ liệu XML lớn và bất kỳ dự án nào cần XPath. Nó cũng là backend được khuyến nghị cho Beautiful Soup khi tốc độ quan trọng.
Giao diện sản phẩm và tổng quan tính năng Top 10 Thư viện Phân tích cú pháp HTML/XML Python 2026.
html5lib là trình phân tích cú pháp HTML thuần Python tuân theo đặc tả HTML5 đầy đủ. Nó phân tích cú pháp HTML chính xác như cách trình duyệt hiện đại làm, khiến nó trở thành trình phân tích cú pháp chính xác nhất để xử lý markup lỗi hoặc không chuẩn.
Điểm mạnh chính:
Hạn chế:
Ví dụ (qua Beautiful Soup):
from bs4 import BeautifulSoup

messy_html = "<div><p>Hello<br>World</div>"
soup = BeautifulSoup(messy_html, 'html5lib')
print(soup.p.text)  # Đầu ra: Hello World
Sử dụng html5lib khi độ chính xác là tối quan trọng và tốc độ không phải là mối quan tâm—ví dụ: khi bạn cần phân tích cú pháp HTML chính xác như trình duyệt để kiểm tra tuân thủ hoặc khi xử lý các trang bị lỗi cực kỳ nghiêm trọng.
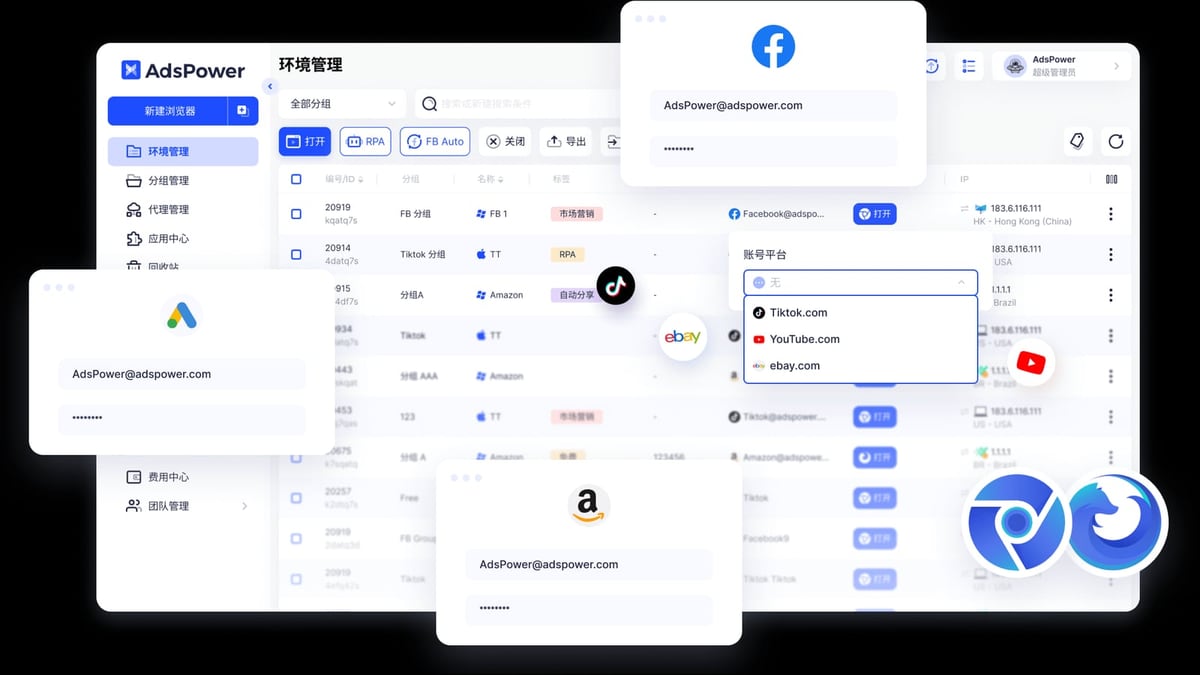
Giao diện sản phẩm và tổng quan tính năng Top 10 Thư viện Phân tích cú pháp HTML/XML Python 2026.
Mô-đun html.parser tích hợp sẵn của Python luôn có sẵn—không cần cài đặt. Nó cung cấp một trình phân tích cú pháp dựa trên sự kiện đơn giản có thể xử lý các tác vụ phân tích cú pháp HTML cơ bản.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from html.parser import HTMLParser

class MyParser(HTMLParser):
    def handle_data(self, data):
        print("Dữ liệu:", data)

parser = MyParser()
parser.feed("<p>Hello World</p>")
html.parser phù hợp nhất cho các tập lệnh nhanh một lần khi bạn kiểm soát chất lượng HTML hoặc trong môi trường không thể cài đặt gói bên thứ ba.
PyQuery mang cú pháp kiểu jQuery vào Python. Nếu bạn có nền tảng front-end, bạn sẽ cảm thấy thoải mái. Nó sử dụng lxml bên dưới để tăng tốc độ.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from pyquery import PyQuery as pq

doc = pq("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(doc(".price").text())  # Đầu ra: $19.99
PyQuery là lựa chọn tuyệt vời cho các nhà phát triển thích mã nhỏ gọn, có thể xâu chuỗi và đã quen với bộ chọn jQuery.
selectolax là một thư viện tương đối mới nhưng mạnh mẽ, bao bọc các công cụ Modest và Lexbor để phân tích cú pháp HTML nhanh với hỗ trợ bộ chọn CSS. Nó được thiết kế cho tốc độ và sử dụng bộ nhớ thấp.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from selectolax.parser import HTMLParser

parser = HTMLParser("<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(parser.css_first('.price').text())  # Đầu ra: $19.99
selectolax lý tưởng cho các pipeline thu thập dữ liệu thông lượng cao khi bộ nhớ và tốc độ là quan trọng và bạn chỉ cần bộ chọn CSS.
Parsel là thư viện đằng sau công cụ chọn của Scrapy. Nó cung cấp một API thống nhất, sạch sẽ để trích xuất dữ liệu bằng bộ chọn CSS và biểu thức XPath, được xây dựng trên lxml.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from parsel import Selector

sel = Selector(text="<div class='product'><h2>Widget</h2><span class='price'>$19.99</span></div>")
print(sel.css('.price::text').get())  # Đầu ra: $19.99
print(sel.xpath('//span[@class="price"]/text()').get())  # Đầu ra: $19.99
Parsel là lựa chọn tuyệt vời nếu bạn muốn một API chọn thống nhất và sau này có thể chuyển sang Scrapy để thu thập dữ liệu quy mô đầy đủ.
Thư viện chuẩn của Python bao gồm xml.etree.ElementTree để phân tích cú pháp và tạo tài liệu XML. Nó nhẹ và đủ cho nhiều tác vụ xử lý XML.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
import xml.etree.ElementTree as ET

xml_data = """<catalog><book id="1"><title>Python 101</title></book></catalog>"""
root = ET.fromstring(xml_data)
print(root.find('.//title').text)  # Đầu ra: Python 101
Sử dụng ElementTree cho tài liệu XML đúng cấu trúc, tệp cấu hình hoặc khi bạn không thể thêm phụ thuộc bên ngoài.
Bảo mật là mối quan tâm quan trọng khi phân tích cú pháp XML từ các nguồn không đáng tin cậy. defusedxml là sự thay thế trực tiếp cho các trình phân tích cú pháp XML tiêu chuẩn, bảo vệ chống lại các cuộc tấn công XML phổ biến như billion laughs và quadratic blowup.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from defusedxml import ElementTree as DET

safe_tree = DET.parse('untrusted.xml')
Luôn sử dụng defusedxml khi phân tích cú pháp XML từ các nguồn bên ngoài hoặc do người dùng cung cấp. Đây là thư viện bắt buộc phải có cho các ứng dụng quan tâm đến bảo mật.
xml.dom.minidom là một triển khai tối thiểu của giao diện Document Object Model (DOM) cho XML. Nó cung cấp cấu trúc cây DOM quen thuộc nhưng nặng hơn ElementTree.
Điểm mạnh chính:
Hạn chế:
Ví dụ:
from xml.dom.minidom import parseString

dom = parseString("<root><item>Dữ liệu</item></root>")
print(dom.getElementsByTagName('item')[0].firstChild.nodeValue)  # Đầu ra: Dữ liệu
minidom hữu ích cho thao tác DOM nhanh của các tài liệu XML nhỏ hoặc khi bạn cần giao diện DOM tiêu chuẩn.
| Thư viện | Tốc độ | Dễ sử dụng | Độ chính xác | Bộ chọn CSS | XPath | Phù hợp nhất cho |
|---|---|---|---|---|---|---|
| Beautiful Soup 4 | Trung bình | Cao | Trung bình | Có | Qua lxml | Người mới bắt đầu, trình thu thập nhanh |
| lxml | Rất cao | Trung bình | Cao | Có | Có | Hiệu suất, XPath |
| html5lib | Thấp | Trung bình | Rất cao | Qua BS4 | Không | Tác vụ yêu cầu độ chính xác |
| html.parser | Cao | Thấp | Thấp | Không | Không | Tập lệnh đơn giản, không phụ thuộc |
| PyQuery | Trung bình | Cao | Trung bình | Có | Không | Người yêu thích jQuery |
| selectolax | Rất cao | Trung bình | Cao | Có | Không | Pipeline thông lượng cao |
| parsel | Cao | Cao | Cao | Có | Có | API chọn thống nhất |
| ElementTree | Cao | Trung bình | Cao (XML) | Không | Hạn chế | Xử lý XML |
| defusedxml | Trung bình | Cao | Cao (XML) | Không | Hạn chế | Phân tích cú pháp XML an toàn |
| minidom | Thấp | Trung bình | Cao (XML) | Không | Không | Tác vụ DOM XML nhỏ |
Lựa chọn của bạn phụ thuộc vào nhu cầu cụ thể:
Thư viện nào tốt nhất cho web scraping năm 2026?
Đối với hầu hết các dự án web scraping, Beautiful Soup 4 với backend lxml cung cấp sự cân bằng tốt nhất giữa dễ sử dụng và hiệu suất. Đối với thu thập dữ liệu quy mô lớn, hãy cân nhắc sử dụng trực tiếp lxml hoặc selectolax.
Tôi có thể sử dụng các thư viện này với trình duyệt chống phát hiện không?
Có. Khi thu thập dữ liệu các trang web có biện pháp chống bot mạnh, bạn có thể kết hợp thư viện phân tích cú pháp với trình duyệt chống phát hiện như AdsPower để quản lý dấu vân tay trình duyệt và tránh bị phát hiện. Ví dụ: bạn có thể sử dụng API cục bộ của AdsPower để điều khiển hồ sơ trình duyệt và cung cấp mã nguồn trang cho Beautiful Soup để phân tích cú pháp. Xem hướng dẫn của chúng tôi về sử dụng AdsPower với Beautiful Soup để thiết lập từng bước.
Tôi có cần học XPath không?
XPath mạnh mẽ nhưng không bắt buộc. Bộ chọn CSS bao phủ hầu hết các trường hợp sử dụng phổ biến. Nếu bạn làm việc với XML hoặc cần truy vấn phức tạp, học XPath là đáng giá.
Có thư viện mới nào trong năm 2026 không?
Selectolax đã trở nên phổ biến nhờ tốc độ và sử dụng bộ nhớ thấp. Hãy theo dõi các công cụ Modest và Lexbor mà nó bao bọc.
Hệ sinh thái phân tích cú pháp HTML và XML của Python năm 2026 đã trưởng thành và đa dạng. Dù bạn là người mới bắt đầu viết trình thu thập dữ liệu đầu tiên hay kỹ sư dữ liệu xây dựng pipeline thông lượng cao, luôn có thư viện phù hợp với nhu cầu của bạn. Beautiful Soup 4 vẫn là lựa chọn hàng đầu cho hầu hết các nhà phát triển, trong khi lxml và selectolax cung cấp hiệu suất vượt trội cho các tác vụ đòi hỏi khắt khe. Đối với XML, các tùy chọn thư viện chuẩn kết hợp với defusedxml cung cấp nền tảng vững chắc.
Hãy nhớ luôn tôn trọng điều khoản dịch vụ trang web và robots.txt khi thu thập dữ liệu. Sử dụng các công cụ thích hợp như proxy và trình duyệt chống phát hiện khi cần thiết và xử lý dữ liệu một cách có trách nhiệm.
Để biết thêm so sánh về các công cụ bổ trợ cho quy trình thu thập dữ liệu của bạn, hãy xem so sánh trình duyệt chống phát hiện của chúng tôi hoặc tìm hiểu về nền tảng dữ liệu thị trường tiền điện tử thường dựa vào các thư viện phân tích cú pháp bên dưới.


